Non ho resistito a provare l’ultima skill ai: Brag ( You built it. Now brag. )
Il mio progettino del weekend ora ha un video di presentazione realizzato con una IA non pensata per generare video. E devo dire che il risultato mi piace molto.
Proudly debugging the system since 1981
Non ho resistito a provare l’ultima skill ai: Brag ( You built it. Now brag. )
Il mio progettino del weekend ora ha un video di presentazione realizzato con una IA non pensata per generare video. E devo dire che il risultato mi piace molto.
C’è un momento in cui un progetto di reverse engineering smette di essere un progetto e diventa un tarlo. YI Home, per me, è stato esattamente questo.
Nel 2019 avevo provato a capire come l’app delle telecamere parlasse con il cloud. Avevo intercettato il traffico HTTPS, individuato l’endpoint di login, capito che la password non era semplicemente hashata ma passava per un HMAC-SHA256 con un segreto. Poi mi ero fermato. Quel segreto non si trovava, il protocollo era più intricato del previsto e il tempo necessario per andare avanti non era compatibile con un hobby. La serie di post si chiudeva con una battuta: “Qualcuno ha qualche PetaFLOP da prestarmi?”
Qualche anno dopo la situazione era peggiorata: l’app funzionava, ma era diventata un condominio di SDK pubblicitari. Avevo ricominciato a guardarla con l’idea di sostituirla, senza però ricadere nella trappola di un progetto infinito.
Negli ultimi mesi REA è circolato molto. Di solito, quando uno strumento fa questo rumore, mi viene il sospetto che sia più spettacolare che utile. Stavolta ho voluto verificare sul campo.
REA, Reverse Engineer Anything, è un MCP: in pratica dà al coding agent una cassetta di attrezzi per guardare dentro un programma. Non si limita a generare codice intorno a un’idea, ma legge l’artefatto, segue le chiamate, recupera funzioni e dati, e restituisce all’agente il materiale su cui ragionare. È il tipo di strumento che cambia il modo in cui poni le domande: non “scrivimi un’app”, ma “come funziona questo pezzo?” e poi “ricostruiscilo”.
Il punto di partenza era ovvio: https://rea.tools/.
Ho preso l’APK di YI Home 6.9.9 e l’ho messo davanti all’agente. Non è un’app Java con un paio di REST: è un runtime ibrido con dieci DEX, un modulo Flutter compilato, un bundle H5 e lo stack nativo TUTK per il P2P. JADX ha tirato fuori circa 31.864 classi, con 385 errori di decompilazione: non esattamente il terreno ideale per un lavoretto serale.
Ed è qui che REA ha fatto la differenza. L’agente ha potuto seguire il flusso di login, ricostruire la firma delle richieste e individuare la chiave hardcoded usata per l’HMAC della password. La password è un HMAC-SHA256, le chiamate sono firmate con HMAC-SHA1 su token e token_secret, e i media degli eventi sono cifrati. Dettagli che, messi insieme, spiegano perché il tentativo manuale di anni prima si fosse arenato.
Il bello è che non ho dovuto chiedere tutto in un colpo. Ho lavorato a piccoli passi: prima la struttura dell’artefatto, poi il login, poi la lista camere, poi gli eventi. Ogni risposta diventava la base per la domanda successiva. È un modo di lavorare molto più simile a un’indagine che a un prompt unico.
In circa due ore è nato un MVP funzionante: una web app Angular che usa lo stesso account e lo stesso backend dell’app Android.
Ho fatto la prova sul mio account, senza toccare impostazioni, senza eliminare camere e senza modificare nulla. Sono state rilevate quattro telecamere, circa 116 eventi negli ultimi trenta giorni, e i video degli eventi sono stati riprodotti correttamente. La sezione Cloud, per il mio account, restituiva zero clip: non un errore del client, semplicemente il backend non aveva registrazioni da mostrare.
La prima messa online è finita in un 503 per un path sbagliato nel reverse proxy. Corretto il path, la web app è andata su senza altre sorprese. Per ora vive qui: https://yiweb.b0sh.net/
Alla fine il conto era questo:
Il dato sui token fa più scena che altro: è il volume complessivo della sessione, non la quantità di codice scritto. Buona parte è contesto riletto mentre il lavoro andava avanti. Il costo è quello che ho visto io, con il provider che uso; non è un preventivo universale.
Non è un clone completo dell’app. Il live P2P TUTK/Kami non è replicabile da browser senza un bridge nativo, quindi la web app è una console cloud, non un sostituto totale dell’app mobile. Non ho implementato binding delle camere, firmware, push, acquisti o abbonamenti. Sono limiti espliciti, non finte implementazioni.
E non è nemmeno magia. REA non “capisce” l’app al posto tuo: dà all’agente gli occhi per guardarla. La parte di verifica resta fondamentale. Ho controllato le risposte, provato il login, guardato i video e sistemato il deploy. Lo strumento accorcia il percorso, non elimina il giudizio.
Per me la lezione non è “l’AI fa il reverse engineering”. È che il costo di ingresso per certi progetti è crollato.
Prima YI Home era un progetto che richiedeva giorni o settimane per ottenere una singola risposta, e quindi restava archiviato. Oggi ho potuto riaprirlo, capire abbastanza per costruire qualcosa di utile e metterlo online in una sera. Non è poco.
Non so se REA sostituirà il reverse engineering tradizionale. Per me ha già fatto una cosa più interessante: ha reso di nuovo affrontabile un progetto che avevo smesso di considerare tale.
Un modello da circa 180 miliardi di parametri, sul mio PC, con una RTX 3060 da 12 GB. È questa la promessa che mi ha incuriosito e mi ha spinto a provare Strata: dopo una prima sessione di coding, la sensazione è di aver fatto un passo avanti concreto rispetto ai modelli che usavo finora in locale.
Non è soltanto una questione di riuscire ad avviare un modello molto grande. Il punto è riuscire a usarlo con velocità accettabili, un contesto ampio e una qualità che lo renda interessante anche per lavorare sul codice.
Strata è un progetto gratuito e open source che permette di eseguire Qwen3.8-Flash-Next su hardware consumer, distribuendo il lavoro tra GPU, CPU, RAM e SSD. Offre un’interfaccia web e API locali compatibili con OpenAI e Anthropic, così da poter collegare applicazioni e coding agent senza ricorrere a un servizio di inferenza cloud.
Il modello di partenza è notevole: Qwen3.8-Flash-Next conta circa 180 miliardi di parametri complessivi, includendo le componenti n-gram e quelle dedicate alla predizione di più token. Non è però un modello denso di quelle dimensioni: adotta un’architettura Mixture of Experts, che attiva solo una parte degli esperti per ciascun token. Il contesto nativo arriva a 262.144 token.
Strata sfrutta queste caratteristiche per rendere possibile l’esecuzione su un normale PC. La GPU mantiene gli esperti usati più frequentemente, mentre RAM e CPU gestiscono il resto; una grande tabella di lookup risiede invece sull’SSD. Non serve, quindi, far entrare tutto il modello nella VRAM.
I requisiti dichiarati partono da una GPU supportata con almeno 12 GB di VRAM, 32 GB di RAM e circa 80 GB liberi su disco, preferibilmente SSD. Il progetto supporta Windows e Linux e propone diverse varianti del modello in funzione della memoria disponibile.
Ho provato Strata su questa configurazione:
| Componente | Hardware |
|---|---|
| CPU | AMD Ryzen 5 9600X |
| RAM | 32 GB DDR5 |
| Archiviazione | SSD PCIe Gen4 |
| GPU | NVIDIA RTX 3060, 12 GB di VRAM |
| Modello selezionato | Coder |
Con 32 GB di RAM ho scelto la variante Coder, che è anche quella consigliata dal progetto per questa quantità di memoria.
La versione Coder di ISTA-DASLab non è semplicemente una quantizzazione del modello completo: combina la riduzione di precisione dei pesi con il pruning, cioè la rimozione di metà degli esperti. La selezione privilegia le capacità legate al codice e all’uso agentico degli strumenti, accettando una perdita maggiore in altri ambiti.
Il dato interessante è quanto riesca a conservare nei benchmark dichiarati dagli autori: il 91,3% del punteggio del modello originale su SWE-bench Verified e il 98,7% su LiveCodeBench v6. Quindi “oltre il 90% delle capacità” va inteso in relazione a questi test di coding, non come una misura universale dell’intelligenza del modello.
Sul mio PC ho osservato circa 300 token al secondo in prefill, cioè nella lettura del prompt, e circa 30 token al secondo in generazione. Per il modello e l’hardware in gioco, considero queste prestazioni molto buone.
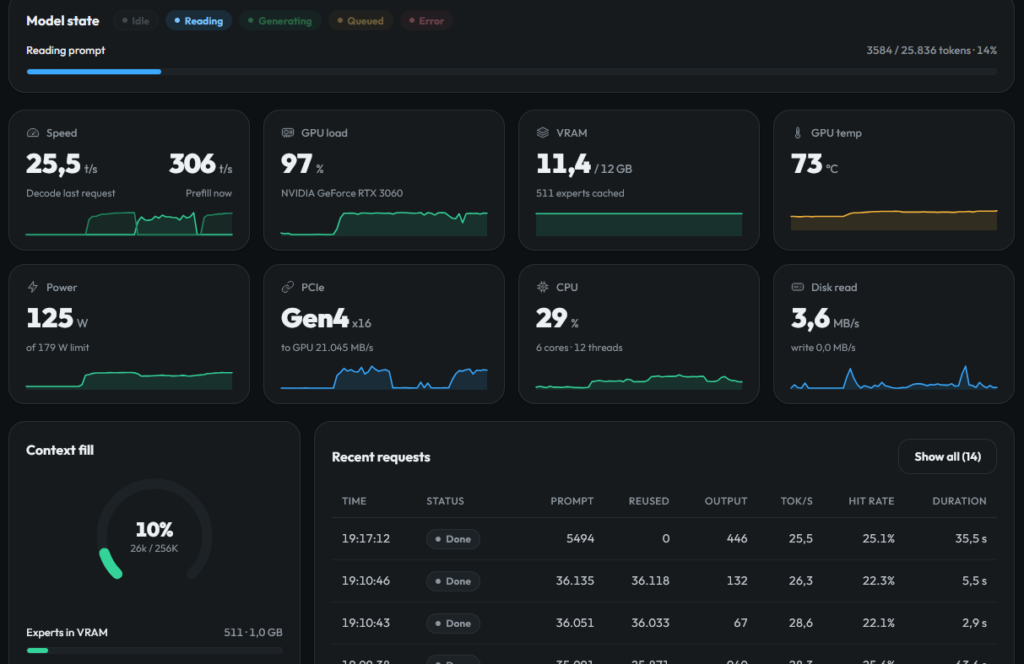
A fine prova, le statistiche erano queste:
| Metrica | Risultato |
|---|---|
| Richieste complessive | 75 |
| Token di prompt elaborati | 284.200 |
| Velocità media di prefill | 286 token/s |
| Token riutilizzati dalla cache | 4.335.358 |
| Token generati | 68.865 |
| Velocità media di generazione | 30,6 token/s |
Sono numeri raccolti durante l’utilizzo, non un benchmark controllato. Descrivono però bene la mia esperienza: la velocità di generazione è sufficiente a rendere il modello concretamente utilizzabile, non soltanto interessante da provare.
La cache è uno degli aspetti che mi hanno colpito di più. Nel corso delle 75 richieste, oltre 4,3 milioni di token sono stati riutilizzati, contro circa 284 mila token effettivamente elaborati in prefill.
Dal punto di vista del tempo di rilettura, quei token recuperati dalla cache sono stati praticamente “gratis”. Nella mia sessione questo ha fatto una differenza importante: il contesto poteva crescere senza dover pagare ogni volta il costo di elaborarlo nuovamente per intero.
Per andare oltre la semplice chat, ho fatto una breve sessione di coding usando OpenCode come harness.
La compressione un po’ si percepisce. Non ho avuto la sensazione di usare il modello originale senza compromessi, e sarebbe prematuro trarre conclusioni definitive da una prova così breve. Detto questo, nella mia esperienza è andato meglio di qualsiasi altro modello locale che abbia usato finora.
Il riferimento precedente era Qwen 3.6 31B, insieme ai relativi fine-tuning e alle diverse quantizzazioni. Rispetto a quella base, Strata con il modello Coder mi è sembrato un netto passo avanti.
Anche il contesto merita attenzione: nella mia configurazione avevo a disposizione 256K token e durante la prova sono arrivato a usarne circa 100K. Non ho quindi verificato il comportamento al limite massimo, ma non ho dovuto ridurre drasticamente la finestra di contesto per rendere il modello utilizzabile sul mio hardware.
Come riferimento cloud uso molto, ultimamente, DeepSeek 4.1 Flash. È il livello di qualità che avevo in mente avvicinandomi a questa prova, ma non ho svolto un confronto diretto e controllato: non considero quindi questa sessione una dimostrazione di equivalenza tra i due.
La parte più interessante di questa esperienza è l’insieme: qualità del codice, circa 30 token al secondo in generazione, un contesto ampio e una cache che nella pratica funziona molto bene.
La compressione comporta dei compromessi, e la mia resta una prima prova. Ma il risultato non è più soltanto “un modello enorme che in qualche modo gira sul PC”: è un modello che ho potuto usare dentro un coding agent, con prestazioni convincenti, su una macchina con 32 GB di RAM e una RTX 3060 da 12 GB.
Per il mio utilizzo, Strata rappresenta un salto concreto rispetto a Qwen 3.6 31B e alle varianti che usavo prima. Non significa che abbia già sostituito i modelli cloud nel mio flusso di lavoro; significa però che il coding locale è diventato un’alternativa molto più credibile.
Audio To Text è ora disponibile in produzione su Google Play: chiunque può scaricare l’app, provarla e inviare feedback direttamente dalla scheda dello store.
👉 Pagina dello store:
https://play.google.com/store/apps/details?id=net.b0sh.audiotext
Da questa fase in poi non è più necessario alcun gruppo o canale separato per i tester: l’open test è aperto a tutti direttamente dallo store.
Audio To Text è un’utilità Android per trascrivere file audio in testo direttamente dal menu Condividi:
Nessun audio lascia il tuo dispositivo: la trascrizione avviene offline, sul telefono. L’unica attività di rete è il download dei modelli dall’interno dell’app.
Il progetto, nato come fork di phone-whisper, è stato progressivamente riprogettato per focalizzarsi sulla trascrizione di file audio condivisi, con un’architettura, un’interfaccia e un flusso d’uso ormai molto diversi rispetto alle origini. Il repository rimane il riferimento principale per dettagli tecnici e storico del progetto.
L’open test parte con la release v1.0.3 (19 settembre 2026), che consolida il lavoro delle versioni 0.9.x e 1.0.x. Le novità più rilevanti rispetto alle prime build di testing:
AudioDecoder prosegue finché il decoder non segnala EOS sull’output, svuotando anche gli ultimi chunk in coda, invece di fermarsi all’EOS in input e chiamare subito stop() (che in alcuni casi scartava la fine dell’audio).Per il dettaglio completo di tutte le modifiche dalle 0.9.x in poi (Jetpack Compose Material 3, navigation bar, download in foreground service, correzioni varie, nuovi modelli, ecc.) puoi consultare il changangelog completo nel README del progetto.
Non è richiesta alcuna configurazione particolare: basta avere un account Google e un dispositivo Android compatibile.
Con l’apertura dell’open test, l’obiettivo è:
Se hai già usato le build di closed testing, l’esperienza è la stessa; la differenza è che ora il canale è aperto a tutti e il feedback può arrivare direttamente da chiunque installi l’app dallo store o apra una issue su GitHub.
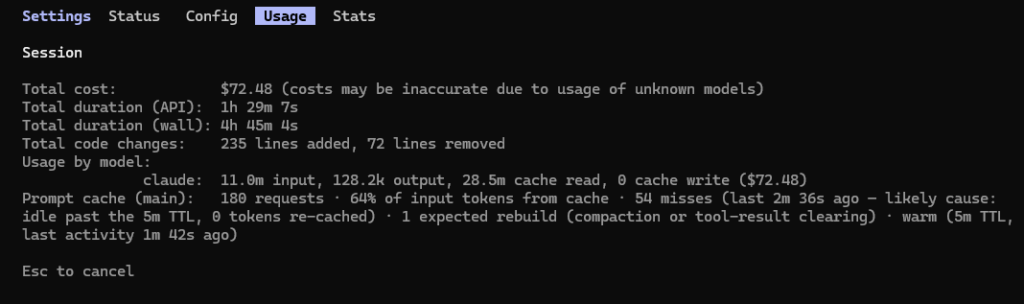
Oggi ho fatto una sessione di debug con Claude Code e alla fine gli ho chiesto le statistiche. Circa 40 milioni di token, cache hit circa al 70% costo stimato 72$.
Peccato che la configurazione in realtà puntasse su openrouter, con deepseek V4 flash come backend. E questi sono i dati reali, non stimati:
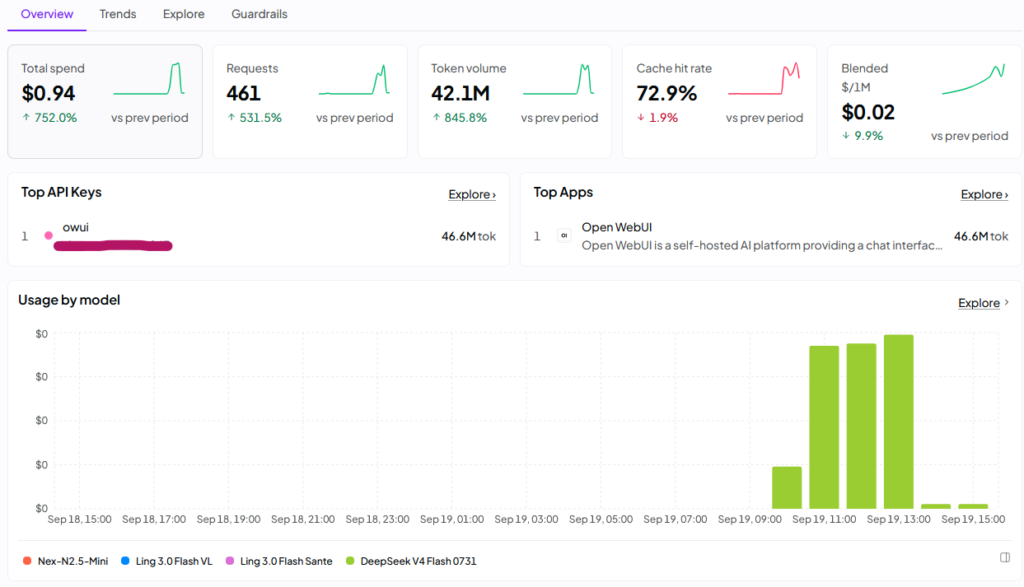
La differenza di costo direi che è notevole. Il provider è stato bloccato su Relace per evitare fluttuazioni di costo e cache miss non graditi.

Dal post di fine agosto è successo parecchio. L’ultima volta vi raccontavo della versione 0.6.3 e dell’avvio del closed testing su Google Play; oggi Audio To Text (ex phone-whisper) è arrivato alla 1.0.0, una release stabile pronta per la fase di test. In questi mesi il lavoro è stato enorme, soprattutto su interfaccia e affidabilità. Vi riassumo i punti principali.
Un’interfaccia tutta nuova
La novità più visibile è la riscrittura completa dell’interfaccia con Jetpack Compose e Material 3. Fino a qualche mese fa la UI era costruita con le classiche View di Android, ora è tutta basata su Compose: tema chiaro/scuro che riusa la palette esistente, animazioni e componenti moderni.
A cambiare è anche la navigazione: al posto dei vecchi bottoni è arrivata una barra di navigazione fissa in basso con tre sezioni — Home, Catalogo e Maggiori informazioni — ognuna con la sua icona (Material Symbols Outlined). La voce attiva è in azzurro, le altre in grigio, e la barra resta sempre visibile. L’onboarding resta una schermata separata, senza barra, con il solo pulsante “Chiudi”.
Un dettaglio che in orizzontale faceva la differenza: nella schermata principale titolo e testo informativo restano fissi, mentre stato e modelli installati scorrono verticalmente. Ora anche con il telefono ruotato tutto funziona come deve.
Download che non si interrompono
Prima, se chiudevi il catalogo mentre uno scaricamento era in corso, il download si fermava. Ora i modelli si scaricano tramite un foreground service: la scaricamento continua in background anche dopo aver premuto Indietro, con una notifica che mostra il progresso. A fine installazione la lista dei modelli installati e il catalogo si aggiornano da soli. È stato anche corretto un bug che, premendo il tasto Indietro durante un download, poteva congelare l’app (ANR).
Catalogo modelli più ricco e gestibile
Il catalogo è cresciuto e ora è più pratico:
Onboarding e piccoli grandi fix
Alla prima apertura ora compare una guida introduttiva con tre schermate scaricabili che spiegano come scaricare il modello, attendere l’installazione e trascrivere un messaggio; si può rivedere in qualsiasi momento dalla sezione “Maggiori informazioni”, dove i link GitHub e Issues sono tornati attivi e aprono correttamente il browser.
Sono stati sistemati anche il crash di Kroko al caricamento (era un modello streaming, ora caricato con il riconoscitore giusto) e il progresso di download per i modelli compressi, che prima saltava da 0% a 100% senza valori intermedi. Le icone del download e del cestino usano ora gli icon set Material Symbols, decisamente più pulite.
Piattaforma
Sotto il cofano: target SDK 36 (Android 16), supporto a tutti gli ABI (arm64, arm, x86, x86_64) per una compatibilità più ampia, e interfaccia multilingua italiano/inglese.
Changelog in breve (0.6.3 → 1.0.0)
Come provarla
La 1.0.0 è pronta per il closed testing su Google Play. Per partecipare basta iscriversi al gruppo dei tester (accesso libero, nessuna mail): https://groups.google.com/g/testers-community/ . Serve solo un dispositivo Android e, se trovi qualcosa che non va — crash, modelli che non si scaricano, traduzioni imprecise — segnalalo pure via Issues o nel gruppo.
La trascrizione resta completamente locale e on-device, con modelli sherpa-onnx: nessuna dipendenza dal cloud. Grazie a chi sta testando e continua a segnalare problemi: è ciò che rende l’app migliore.
Con la versione 0.6.3 di Audio To Text (ex phone-whisper) è partita la fase di closed testing su Google Play. È il passaggio successivo dopo il rebrand e la rimozione delle funzionalità cloud raccontati nel post precedente.
Google Play richiede una fase di test con un gruppo ristretto di utenti prima di poter aprire l’app al pubblico. È un passaggio utile anche a prescindere dall’obbligo: permette di verificare il funzionamento su dispositivi e versioni di Android diverse dalla mia, cosa che da solo non riesco a coprire.
L’app è visibile alla pagina Google Play di Audio To Text, ma per installarla in questa fase è necessario essere inseriti nella lista dei tester.
Chi vuole provarla lo può fare iscrivendosi al gruppo dei tester su google group: https://groups.google.com/g/testers-community/ . Il gruppo è ad accesso libero e non manda nessuna mail. Non serve nessuna competenza particolare, solo un dispositivo Android e la disponibilità a segnalare eventuali problemi — crash, modelli che non si scaricano correttamente, traduzioni imprecise o altro.
La versione in test corrisponde a quella descritta nel post precedente: trascrizione locale con modelli sherpa-onnx, nessuna dipendenza cloud, interfaccia in italiano o inglese in base alla lingua del dispositivo.
v0.6.3 (2026-08-27)
C’è stato un cambiamento importante: nasce Audio To Text
Ad aprile avevo raccontato la nascita di phone-whisper, l’app Android per trascrivere audio offline sul dispositivo usando sherpa-onnx (potete rileggere il post originale). Da allora il progetto è cresciuto, e con la versione 0.6.1 arriva un cambiamento che va oltre il semplice numero di release: l’app cambia nome e diventa Audio To Text.
Il progetto nasceva già con un forte focus sulla privacy, ma manteneva un’integrazione opzionale con OpenAI per la trascrizione cloud e il post-processing del testo. Con la 0.6.0 questa parte è stata rimossa completamente: niente più chiamate cloud, niente API key da gestire, nessun dato che lascia il telefono. L’app oggi funziona esclusivamente con i modelli sherpa-onnx scaricati e installati in locale, il che significa anche una base di codice più semplice da mantenere — sono stati eliminati interi componenti come TranscriberClient, PostProcessor e WavWriter, insieme ai relativi test.
Questa scelta ha richiesto anche una riscrittura della privacy policy, per rimuovere ogni riferimento alla gestione delle chiavi API e alle modalità cloud che non esistono più.
Il nome phone-whisper aveva senso quando il progetto era ancora legato all’idea di Whisper e a un’integrazione cloud. Ora che l’app è diventata a tutti gli effetti uno strumento locale, ho deciso di rinominarla Audio To Text, un nome più diretto e descrittivo di quello che fa realmente. Il cambiamento non è solo estetico: il package dei sorgenti è stato spostato da com.kafkasl.phonewhisper a net.b0sh.audiotext, con la cronologia Git preservata grazie a un git mv mirato invece di una semplice riscrittura dei file.
Con la 0.6.0 e la 0.6.1 ho lavorato molto anche su come l’app comunica il proprio stato all’utente:
L’obiettivo originale di phone-whisper era offrire una trascrizione privata e locale, ma la presenza di un’opzione cloud era in qualche modo in contrasto con quella filosofia. Rimuoverla non è stata solo una semplificazione tecnica: è stata anche una scelta di coerenza. Audio To Text è oggi un’app che fa una cosa sola, la fa completamente offline, e non ha bisogno di chiedere permessi di rete o gestire credenziali di terzi.
v0.6.1 (2026-08-25)
v0.6.0 (2026-08-25)
net.b0sh.audiotext.Audio To Text resta un progetto piccolo, ma ora è coerente al 100% con la sua promessa iniziale: nessun dato lascia il tuo telefono, mai.
Negli ultimi mesi ho notato un cambio di passo netto nella qualità dei modelli LLM eseguibili in locale. Non è la prima volta che scrivo di questo argomento su questo blog (chi segue il tag Ollama lo sa bene), ma stavolta la sensazione è diversa: non si tratta più di rincorrere il cloud con modelli “dignitosi per essere locali”, ma di avvicinarsi seriamente a prestazioni che fino a poco tempo fa erano appannaggio esclusivo dei giganti closed source.
Il modello che per me ha segnato la svolta è Qwen 3.6 31B. Non è la potenza bruta in sé a colpire, quanto la qualità delle rielaborazioni che la community ha saputo tirarne fuori.
Due versioni GGUF mi hanno impressionato particolarmente:
Nei miei test di coding e debug, entrambe le versioni si comportano molto bene, specialmente se abbinate all’harness ufficiale Qwen Code (qwen.ai/qwencode). La combinazione modello-tooling fa davvero la differenza: non basta un buon modello, serve un ecosistema che lo sappia sfruttare.
Se Qwen 3.6 mi aveva già convinto, oggi ho provato qualcosa che alza ulteriormente l’asticella: Agent A1 di InternScience (huggingface.co/InternScience/Agents-A1). I benchmark che presenta lo pongono a un livello paragonabile a modelli closed source molto più grandi, e non è la prima volta che vedo un modello “piccolo” (in senso relativo) tenere testa a giganti da centinaia di miliardi di parametri.
È il tipo di risultato che ti fa fermare un attimo e chiederti: dove sta andando davvero questo settore?
Questo mi porta alla domanda che mi frulla in testa da settimane: chi vincerà, alla fine, tra cloud e inferenza locale?
Da una parte, il cloud closed source vive ancora una fase “dorata” grazie ai capitali enormi investiti da attori come OpenAI, Anthropic e compagnia. Questo ha reso possibile offrire inferenza a prezzi vantaggiosi, spesso sussidiati, pur di conquistare quote di mercato. È un classico schema da economia digitale: brucia cassa oggi, guadagna posizione domani.
Dall’altra parte, l’inferenza locale sta crescendo a una velocità sorprendente, ma per motivi completamente diversi: non capitali enormi, bensì ottimizzazione pura. Quantizzazione, tecniche come MTP, architetture MoE sempre più efficienti: tutto questo sta permettendo a hardware consumer di fare cose impensabili solo un paio di anni fa.
Al momento, il cloud vince ancora, e probabilmente vincerà ancora per un po’. Ma la vera domanda è cosa succederà quando il mercato selezionerà un vincitore (o pochi vincitori) tra i provider closed source. In quel momento, chi resterà in piedi dovrà necessariamente far pagare l’inferenza a un prezzo che rifletta davvero i costi (e gli investimenti da recuperare). È lì che si aprirà la vera partita.
Se a quel punto l’hardware consumer sarà abbastanza potente, e i modelli open abbastanza ottimizzati, avremo finalmente un’alternativa concreta e sostenibile al cloud a pagamento. Non lo so con certezza, ma spero che il ritmo di miglioramento dei modelli open continui così: non tanto per “battere” il cloud, quanto per garantire che un’alternativa esista sempre. Perché in un mercato senza alternative, alla fine, a pagare il conto siamo sempre noi.
C’è un momento, per chi naviga il web da abbastanza tempo, in cui capisci che un servizio chiuso non è mai stato davvero sostituito. Per me quel servizio era Delicious.
Chi se lo ricorda sa di cosa parlo: un modo semplice per salvare i segnalibri, taggarli, e condividerli con altri. Quando Delicious ha chiuso i battenti, ho passato anni a provare alternative — estensioni, servizi cloud, note app riadattate — senza trovare niente che replicasse quel flusso naturale: trovo un sito interessante, lo salvo con un click, lo condivido con chi mi segue. Alla fine ho deciso di risolvere il problema alla vecchia maniera: scrivendomi l’alternativa da solo.
È nato così BookmarkFox, un’estensione per Firefox che comunica con un backend web per pubblicare i segnalibri. Niente di rivoluzionario nell’idea, ma è esattamente quello che mi serviva — e visto che non esisteva, l’ho costruito.
Le opzioni moderne per gestire segnalibri condivisibili sono o troppo pesanti (servizi enterprise di bookmarking/knowledge management) o troppo chiuse in un ecosistema (salvataggi legati a un singolo social o browser). Mancava qualcosa di leggero, personale, e soprattutto self-hosted: un’estensione che facesse una cosa sola, bene, e che mi lasciasse controllo pieno sui dati.
BookmarkFox nasce da questa esigenza precisa: un’estensione Firefox minimale che pubblica i segnalibri su un backend che gestisco io, raggiungibile su bookmarkfox.b0sh.net.
La parte che mi interessa raccontare di più, però, non è il “cosa” ma il “come”. Negli ultimi tempi ho sviluppato diversi progettini con l’aiuto di modelli AI locali o via API, e il pattern tipico è quello del prompt libero seguito da iterazioni a ruota libera. Funziona, ma con progetti che superano una certa complessità il modello perde il filo, e tu perdi tempo a rispiegare il contesto ogni volta.
Per BookmarkFox ho voluto provare un approccio più strutturato, usando GitHub SpecKit insieme a OpenCode. L’idea di SpecKit è semplice ma efficace:
Il vantaggio pratico? Un modello non enorme — nel mio caso DeepSeek V4 Flash, con 250k di contesto — riesce a lavorare bene su singole task senza dover tenere “in mente” tutta l’architettura del progetto contemporaneamente. Ogni task è autoconclusiva, con contesto sufficiente ma non eccessivo. Il risultato è un workflow più prevedibile, meno “allucinazioni” da perdita di contesto, e codice più coerente con l’architettura pensata a monte.
È un cambio di paradigma interessante: non si tratta di usare un modello più potente, ma di strutturare meglio il problema perché anche un modello più leggero possa affrontarlo con efficacia. Per chi lavora con LLM locali o con budget di context window limitati, è una lezione che vale la pena portarsi a casa.
BookmarkFox oggi è operativo:
Non è (ancora) Delicious 2.0, ma è già quello che mi serviva: un modo veloce per salvare e condividere i siti interessanti che trovo in giro, senza dipendere da un servizio terzo che può chiudere domani.
Al di là del progetto in sé, l’esperienza con SpecKit mi ha convinto che il futuro dell’AI-assisted coding per progetti non banali passa da qui: meno prompt-e-spera, più analisi-chiarifica-scomponi. È un investimento di tempo iniziale che si ripaga abbondantemente quando il progetto cresce oltre le due-tre funzioni.
Se usi Firefox e ti manca un modo semplice per salvare e condividere segnalibri, dai un’occhiata a BookmarkFox. E se sei curioso di provare tu stesso il workflow SpecKit + LLM locale, è un ottimo punto di partenza per progetti di dimensioni simili.
© 2026 b0sh.net
Tema di Anders Noren — Su ↑