Proudly debugging the system since 1981

Tag: ai (Pagina 1 di 3)

Strata: coding locale con una RTX 3060

Un modello da circa 180 miliardi di parametri, sul mio PC, con una RTX 3060 da 12 GB. È questa la promessa che mi ha incuriosito e mi ha spinto a provare Strata: dopo una prima sessione di coding, la sensazione è di aver fatto un passo avanti concreto rispetto ai modelli che usavo finora in locale.

Non è soltanto una questione di riuscire ad avviare un modello molto grande. Il punto è riuscire a usarlo con velocità accettabili, un contesto ampio e una qualità che lo renda interessante anche per lavorare sul codice.

Che cos’è Strata

Strata è un progetto gratuito e open source che permette di eseguire Qwen3.8-Flash-Next su hardware consumer, distribuendo il lavoro tra GPU, CPU, RAM e SSD. Offre un’interfaccia web e API locali compatibili con OpenAI e Anthropic, così da poter collegare applicazioni e coding agent senza ricorrere a un servizio di inferenza cloud.

Il modello di partenza è notevole: Qwen3.8-Flash-Next conta circa 180 miliardi di parametri complessivi, includendo le componenti n-gram e quelle dedicate alla predizione di più token. Non è però un modello denso di quelle dimensioni: adotta un’architettura Mixture of Experts, che attiva solo una parte degli esperti per ciascun token. Il contesto nativo arriva a 262.144 token.

Strata sfrutta queste caratteristiche per rendere possibile l’esecuzione su un normale PC. La GPU mantiene gli esperti usati più frequentemente, mentre RAM e CPU gestiscono il resto; una grande tabella di lookup risiede invece sull’SSD. Non serve, quindi, far entrare tutto il modello nella VRAM.

I requisiti dichiarati partono da una GPU supportata con almeno 12 GB di VRAM, 32 GB di RAM e circa 80 GB liberi su disco, preferibilmente SSD. Il progetto supporta Windows e Linux e propone diverse varianti del modello in funzione della memoria disponibile.

Il mio PC e il modello

Ho provato Strata su questa configurazione:

ComponenteHardware
CPUAMD Ryzen 5 9600X
RAM32 GB DDR5
ArchiviazioneSSD PCIe Gen4
GPUNVIDIA RTX 3060, 12 GB di VRAM
Modello selezionatoCoder

Con 32 GB di RAM ho scelto la variante Coder, che è anche quella consigliata dal progetto per questa quantità di memoria.

La versione Coder di ISTA-DASLab non è semplicemente una quantizzazione del modello completo: combina la riduzione di precisione dei pesi con il pruning, cioè la rimozione di metà degli esperti. La selezione privilegia le capacità legate al codice e all’uso agentico degli strumenti, accettando una perdita maggiore in altri ambiti.

Il dato interessante è quanto riesca a conservare nei benchmark dichiarati dagli autori: il 91,3% del punteggio del modello originale su SWE-bench Verified e il 98,7% su LiveCodeBench v6. Quindi “oltre il 90% delle capacità” va inteso in relazione a questi test di coding, non come una misura universale dell’intelligenza del modello.

Le prestazioni sul campo

Sul mio PC ho osservato circa 300 token al secondo in prefill, cioè nella lettura del prompt, e circa 30 token al secondo in generazione. Per il modello e l’hardware in gioco, considero queste prestazioni molto buone.
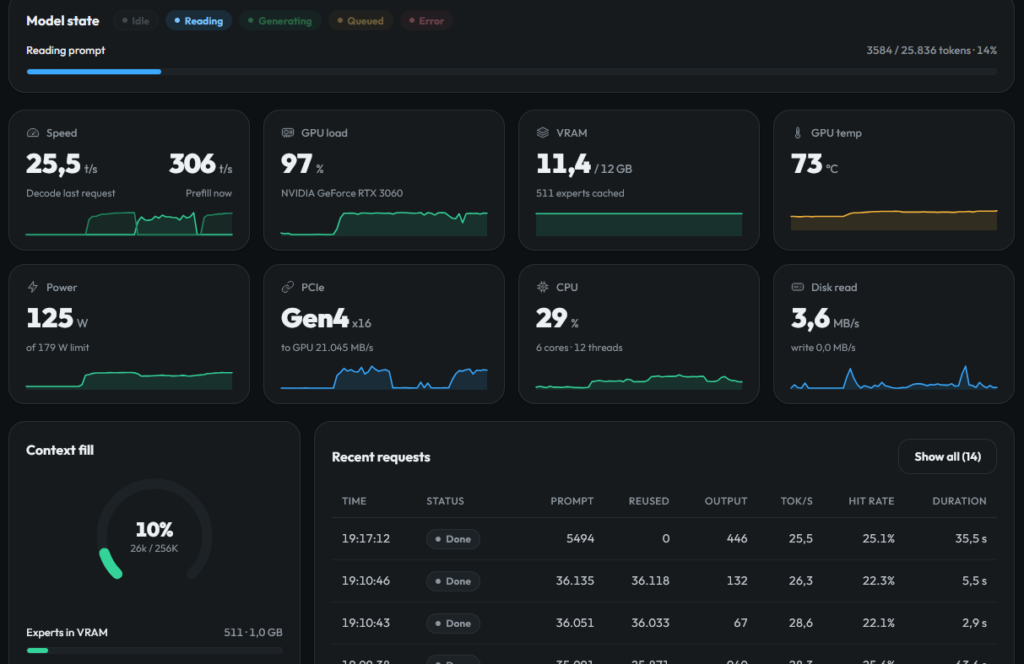
A fine prova, le statistiche erano queste:

MetricaRisultato
Richieste complessive75
Token di prompt elaborati284.200
Velocità media di prefill286 token/s
Token riutilizzati dalla cache4.335.358
Token generati68.865
Velocità media di generazione30,6 token/s

Sono numeri raccolti durante l’utilizzo, non un benchmark controllato. Descrivono però bene la mia esperienza: la velocità di generazione è sufficiente a rendere il modello concretamente utilizzabile, non soltanto interessante da provare.

La cache è uno degli aspetti che mi hanno colpito di più. Nel corso delle 75 richieste, oltre 4,3 milioni di token sono stati riutilizzati, contro circa 284 mila token effettivamente elaborati in prefill.

Dal punto di vista del tempo di rilettura, quei token recuperati dalla cache sono stati praticamente “gratis”. Nella mia sessione questo ha fatto una differenza importante: il contesto poteva crescere senza dover pagare ogni volta il costo di elaborarlo nuovamente per intero.

Coding con OpenCode

Per andare oltre la semplice chat, ho fatto una breve sessione di coding usando OpenCode come harness.

La compressione un po’ si percepisce. Non ho avuto la sensazione di usare il modello originale senza compromessi, e sarebbe prematuro trarre conclusioni definitive da una prova così breve. Detto questo, nella mia esperienza è andato meglio di qualsiasi altro modello locale che abbia usato finora.

Il riferimento precedente era Qwen 3.6 31B, insieme ai relativi fine-tuning e alle diverse quantizzazioni. Rispetto a quella base, Strata con il modello Coder mi è sembrato un netto passo avanti.

Anche il contesto merita attenzione: nella mia configurazione avevo a disposizione 256K token e durante la prova sono arrivato a usarne circa 100K. Non ho quindi verificato il comportamento al limite massimo, ma non ho dovuto ridurre drasticamente la finestra di contesto per rendere il modello utilizzabile sul mio hardware.

Come riferimento cloud uso molto, ultimamente, DeepSeek 4.1 Flash. È il livello di qualità che avevo in mente avvicinandomi a questa prova, ma non ho svolto un confronto diretto e controllato: non considero quindi questa sessione una dimostrazione di equivalenza tra i due.

Un passo avanti concreto

La parte più interessante di questa esperienza è l’insieme: qualità del codice, circa 30 token al secondo in generazione, un contesto ampio e una cache che nella pratica funziona molto bene.

La compressione comporta dei compromessi, e la mia resta una prima prova. Ma il risultato non è più soltanto “un modello enorme che in qualche modo gira sul PC”: è un modello che ho potuto usare dentro un coding agent, con prestazioni convincenti, su una macchina con 32 GB di RAM e una RTX 3060 da 12 GB.

Per il mio utilizzo, Strata rappresenta un salto concreto rispetto a Qwen 3.6 31B e alle varianti che usavo prima. Non significa che abbia già sostituito i modelli cloud nel mio flusso di lavoro; significa però che il coding locale è diventato un’alternativa molto più credibile.
Costo Claude Code vs Deepseek

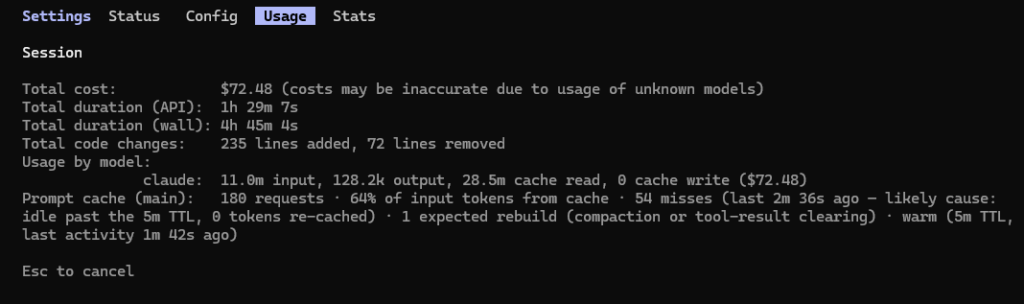
Oggi ho fatto una sessione di debug con Claude Code e alla fine gli ho chiesto le statistiche. Circa 40 milioni di token, cache hit circa al 70% costo stimato 72$.

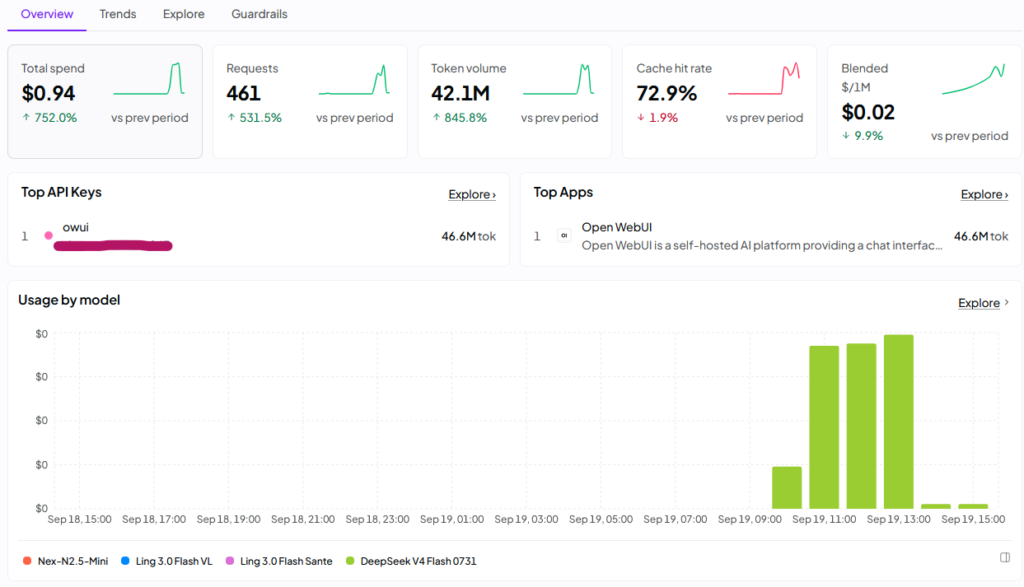
Peccato che la configurazione in realtà puntasse su openrouter, con deepseek V4 flash come backend. E questi sono i dati reali, non stimati:

La differenza di costo direi che è notevole. Il provider è stato bloccato su Relace per evitare fluttuazioni di costo e cache miss non graditi.

Audio To Text arriva alla 1.0.0: ecco che cosa è cambiato

Dal post di fine agosto è successo parecchio. L’ultima volta vi raccontavo della versione 0.6.3 e dell’avvio del closed testing su Google Play; oggi Audio To Text (ex phone-whisper) è arrivato alla 1.0.0, una release stabile pronta per la fase di test. In questi mesi il lavoro è stato enorme, soprattutto su interfaccia e affidabilità. Vi riassumo i punti principali.

Un’interfaccia tutta nuova

La novità più visibile è la riscrittura completa dell’interfaccia con Jetpack Compose e Material 3. Fino a qualche mese fa la UI era costruita con le classiche View di Android, ora è tutta basata su Compose: tema chiaro/scuro che riusa la palette esistente, animazioni e componenti moderni.

A cambiare è anche la navigazione: al posto dei vecchi bottoni è arrivata una barra di navigazione fissa in basso con tre sezioni — Home, Catalogo e Maggiori informazioni — ognuna con la sua icona (Material Symbols Outlined). La voce attiva è in azzurro, le altre in grigio, e la barra resta sempre visibile. L’onboarding resta una schermata separata, senza barra, con il solo pulsante “Chiudi”.

Un dettaglio che in orizzontale faceva la differenza: nella schermata principale titolo e testo informativo restano fissi, mentre stato e modelli installati scorrono verticalmente. Ora anche con il telefono ruotato tutto funziona come deve.

Download che non si interrompono

Prima, se chiudevi il catalogo mentre uno scaricamento era in corso, il download si fermava. Ora i modelli si scaricano tramite un foreground service: la scaricamento continua in background anche dopo aver premuto Indietro, con una notifica che mostra il progresso. A fine installazione la lista dei modelli installati e il catalogo si aggiornano da soli. È stato anche corretto un bug che, premendo il tasto Indietro durante un download, poteva congelare l’app (ANR).

Catalogo modelli più ricco e gestibile

Il catalogo è cresciuto e ora è più pratico:

  • Nuovi modelli, tra cui Kroko Italiano, dedicato alla trascrizione dell’italiano, scaricato come file singoli direttamente da Hugging Face.
  • Rimozione dei modelli: i modelli installati si possono eliminare (con conferma) per liberare spazio; il modello attivo, se rimosso, viene riselezionato automaticamente con il primo installato rimasto.
  • Nomi più chiari: ogni modello indica la lingua di destinazione (es. “Whisper Base – English”, “Parakeet 0.6B – Multilanguage”).
  • Supporto per modelli compressi e non, e per fonti di download diverse.

Onboarding e piccoli grandi fix

Alla prima apertura ora compare una guida introduttiva con tre schermate scaricabili che spiegano come scaricare il modello, attendere l’installazione e trascrivere un messaggio; si può rivedere in qualsiasi momento dalla sezione “Maggiori informazioni”, dove i link GitHub e Issues sono tornati attivi e aprono correttamente il browser.

Sono stati sistemati anche il crash di Kroko al caricamento (era un modello streaming, ora caricato con il riconoscitore giusto) e il progresso di download per i modelli compressi, che prima saltava da 0% a 100% senza valori intermedi. Le icone del download e del cestino usano ora gli icon set Material Symbols, decisamente più pulite.

Piattaforma

Sotto il cofano: target SDK 36 (Android 16), supporto a tutti gli ABI (arm64, arm, x86, x86_64) per una compatibilità più ampia, e interfaccia multilingua italiano/inglese.

Changelog in breve (0.6.3 → 1.0.0)

  • v1.0.0 — Prima release stabile per il closed testing: consolida tutta la serie 0.9.x.
  • v0.9.x — Migrazione Jetpack Compose Material 3, barra di navigazione in basso, download in background (foreground service), fix ANR/auto-riselezione/link/scroll orizzontale, icone Material Symbols, fix Kroko, progresso download compressi, chiarezza catalogo, nuovi modelli (Kroko Italiano), onboarding e indicatori.
  • v0.8.x — Rimozione modelli installati, supporto a tutti gli ABI, promozioni al closed testing.
  • v0.7.0 — Promozione al closed testing.
  • v0.6.4–0.6.6 — Target SDK 36, schermata “Maggiori informazioni”, fix UI e contrasto.

Come provarla

La 1.0.0 è pronta per il closed testing su Google Play. Per partecipare basta iscriversi al gruppo dei tester (accesso libero, nessuna mail): https://groups.google.com/g/testers-community/ . Serve solo un dispositivo Android e, se trovi qualcosa che non va — crash, modelli che non si scaricano, traduzioni imprecise — segnalalo pure via Issues o nel gruppo.

La trascrizione resta completamente locale e on-device, con modelli sherpa-onnx: nessuna dipendenza dal cloud. Grazie a chi sta testando e continua a segnalare problemi: è ciò che rende l’app migliore.

Audio To Text in closed testing su Google Play

Con la versione 0.6.3 di Audio To Text (ex phone-whisper) è partita la fase di closed testing su Google Play. È il passaggio successivo dopo il rebrand e la rimozione delle funzionalità cloud raccontati nel post precedente.

Cos’è il closed testing

Google Play richiede una fase di test con un gruppo ristretto di utenti prima di poter aprire l’app al pubblico. È un passaggio utile anche a prescindere dall’obbligo: permette di verificare il funzionamento su dispositivi e versioni di Android diverse dalla mia, cosa che da solo non riesco a coprire.

L’app è visibile alla pagina Google Play di Audio To Text, ma per installarla in questa fase è necessario essere inseriti nella lista dei tester.

Come partecipare

Chi vuole provarla lo può fare iscrivendosi al gruppo dei tester su google group: https://groups.google.com/g/testers-community/ . Il gruppo è ad accesso libero e non manda nessuna mail. Non serve nessuna competenza particolare, solo un dispositivo Android e la disponibilità a segnalare eventuali problemi — crash, modelli che non si scaricano correttamente, traduzioni imprecise o altro.

Cosa trovare nell’app

La versione in test corrisponde a quella descritta nel post precedente: trascrizione locale con modelli sherpa-onnx, nessuna dipendenza cloud, interfaccia in italiano o inglese in base alla lingua del dispositivo.

Changelog

v0.6.3 (2026-08-27)

Da phone-whisper a Audio To Text: rebrand, local-only e UI più chiara

C’è stato un cambiamento importante: nasce Audio To Text

Ad aprile avevo raccontato la nascita di phone-whisper, l’app Android per trascrivere audio offline sul dispositivo usando sherpa-onnx (potete rileggere il post originale). Da allora il progetto è cresciuto, e con la versione 0.6.1 arriva un cambiamento che va oltre il semplice numero di release: l’app cambia nome e diventa Audio To Text.

Cosa cambia davvero

Il progetto nasceva già con un forte focus sulla privacy, ma manteneva un’integrazione opzionale con OpenAI per la trascrizione cloud e il post-processing del testo. Con la 0.6.0 questa parte è stata rimossa completamente: niente più chiamate cloud, niente API key da gestire, nessun dato che lascia il telefono. L’app oggi funziona esclusivamente con i modelli sherpa-onnx scaricati e installati in locale, il che significa anche una base di codice più semplice da mantenere — sono stati eliminati interi componenti come TranscriberClient, PostProcessor e WavWriter, insieme ai relativi test.

Questa scelta ha richiesto anche una riscrittura della privacy policy, per rimuovere ogni riferimento alla gestione delle chiavi API e alle modalità cloud che non esistono più.

Il rebrand: da phone-whisper a Audio To Text

Il nome phone-whisper aveva senso quando il progetto era ancora legato all’idea di Whisper e a un’integrazione cloud. Ora che l’app è diventata a tutti gli effetti uno strumento locale, ho deciso di rinominarla Audio To Text, un nome più diretto e descrittivo di quello che fa realmente. Il cambiamento non è solo estetico: il package dei sorgenti è stato spostato da com.kafkasl.phonewhisper a net.b0sh.audiotext, con la cronologia Git preservata grazie a un git mv mirato invece di una semplice riscrittura dei file.

Miglioramenti all’esperienza utente

Con la 0.6.0 e la 0.6.1 ho lavorato molto anche su come l’app comunica il proprio stato all’utente:

  • Durante l’installazione di un modello, ora viene mostrato il progresso di estrazione con numero di file completati e file corrente in lavorazione, così sai esattamente a che punto è il processo.
  • È stata aggiunta una sezione informativa sullo stato del modello nella schermata principale, per capire a colpo d’occhio se un modello è installato, pronto o ancora da scaricare.
  • Con la 0.6.1 arriva il supporto multilingua dell’interfaccia: l’app segue automaticamente la lingua del dispositivo tra inglese e italiano. Nome dell’app e nomi dei modelli restano invariati, per evitare ambiguità.

Perché questo cambiamento

L’obiettivo originale di phone-whisper era offrire una trascrizione privata e locale, ma la presenza di un’opzione cloud era in qualche modo in contrasto con quella filosofia. Rimuoverla non è stata solo una semplificazione tecnica: è stata anche una scelta di coerenza. Audio To Text è oggi un’app che fa una cosa sola, la fa completamente offline, e non ha bisogno di chiedere permessi di rete o gestire credenziali di terzi.

Changelog completo

v0.6.1 (2026-08-25)

  • Interfaccia multilingua: supporto inglese e italiano, in base alla lingua del dispositivo. Nome app e nomi modelli non tradotti.
  • Aggiornamento versione: 0.6.0 → 0.6.1 (versionCode 8).

v0.6.0 (2026-08-25)

  • Rimossa l’integrazione OpenAI: eliminate trascrizione cloud e post-processing. L’app supporta ora solo la trascrizione locale con modelli sherpa-onnx scaricati.
  • Rebrand: l’app è stata rinominata Audio To Text, package spostato in net.b0sh.audiotext.
  • Aggiornamento versione: 0.5.0 → 0.6.0 (versionCode 7).

Link utili

Audio To Text resta un progetto piccolo, ma ora è coerente al 100% con la sua promessa iniziale: nessun dato lascia il tuo telefono, mai.

Ho costruito un selezionatore AI per scegliere le foto migliori da PhotoPrism

Tornare da un viaggio significa quasi sempre ritrovarsi con una quantità ingestibile di foto. Nel caso di Lisbona, il problema non era tanto archiviare gli scatti, quanto riuscire a estrarne una ventina davvero condivisibile: belle, sì, ma anche varie e capaci di raccontare l’esperienza nel suo insieme. PhotoPrism offriva già un’ottima base grazie a geolocalizzazione, riconoscimento facciale, label e strumenti di organizzazione, ma non aveva ancora un modo per comporre automaticamente un album con “le foto più belle” e soprattutto con sufficiente varietà.

Da qui è nata l’idea di un selezionatore AI: una piccola applicazione Java che usa PhotoPrism per recuperare le miniature delle immagini e Ollama per far lavorare due modelli AI, uno multimodale per assegnare un punteggio estetico e produrre una descrizione oggettiva, e un secondo modello testuale per raggruppare semanticamente le foto e selezionarle con più equilibrio.

Il problema vero non era la qualità

Il primo prototipo faceva una cosa molto semplice: prendere le foto da PhotoPrism, inviarle a un modello multimodale su Ollama e chiedere un voto estetico da 1 a 100 insieme a una breve descrizione. Sulla carta sembrava sufficiente, ma in pratica produceva una selezione monotona: immagini molto belle singolarmente, ma spesso troppo simili tra loro.

Era il classico caso in cui un ranking puro ottimizza la qualità locale ma non la copertura narrativa. Se cinque foto dello stesso scorcio o dello stesso momento ricevono voti alti, un algoritmo ingenuo tende a sceglierle tutte. Per costruire un album da condividere, invece, non basta premiare le immagini migliori: bisogna anche evitare la ripetizione.

Continua a leggere

Ha ancora senso usare N8N? Un esperimento con Gemini CLI mi ha fatto cambiare idea

Per chi mi segue da un po’, sa che ho usato N8N come strumento di riferimento ogni volta che volevo integrare l’AI in un processo senza scrivere codice da zero. Workflow visivi, nodi preconfigurati, integrazioni pronte: per prototipare rapidamente è stato spesso la scelta giusta.

Ma ultimamente mi sono fatto una domanda: ha ancora senso usare N8N nel 2026, ora che gli strumenti di codifica AI sono diventati così potenti?

L’esperimento

Avevo un workflow N8N che usavo per trascrivere e sintetizzare registrazioni video — niente di esoterico, ma un processo abbastanza articolato: estrazione audio, chiamata a un modello di trascrizione, sintesi con un LLM, output strutturato. Funzionava, ma con i suoi limiti: dimensione massima dei file in ingresso, dipendenza dall’infrastruttura N8N, e quella sensazione di lavorare “dentro una scatola”.

Ho deciso di provare a riscrivere l’intero flusso come programma standalone. Gli strumenti? Gemini CLI come agente di codifica, il JSON del workflow N8N come specifica di partenza, e un prompt abbastanza dettagliato su cosa volessi ottenere.

Il risultato (che mi ha sorpreso)

In poche decine di minuti avevo un programma funzionante da riga di comando. Non un prototipo traballante: un tool che funziona meglio del workflow N8N originale, senza i limiti sulla dimensione dei file e con un controllo molto più diretto su ogni fase del processo.

Ho scelto deliberatamente la CLI perché l’uso che immagino è locale e sporadico — nessun senso di tirar su un’infrastruttura per qualcosa che uso una volta alla settimana. Ma sarebbe stato altrettanto semplice chiedere a Gemini CLI di generare un’app che espone un webservice: il delta di complessità sarebbe stato minimo.

La cosa che mi ha colpito di più non è tanto la velocità, ma quanto sia stato naturale usare il JSON di N8N come prompt implicito. Il workflow descriveva già la logica del processo in modo strutturato; Gemini ha semplicemente tradotto quella struttura in codice Java coerente e funzionante.

Cosa cambia (e cosa no)

N8N rimane uno strumento valido per certi scenari: team non tecnici, integrazioni con decine di servizi SaaS, processi che devono girare su scheduler senza infrastruttura dedicata. Non sto dicendo che sia morto.

Ma per chi sa usare il terminale e ha accesso a un buon agente di codifica AI, il vantaggio principale di N8N — abbassare la barriera tecnica — si è assottigliato enormemente. Il codice generato è leggibile, manutenibile, e non ha i vincoli architetturali di una piattaforma generalista.

Il codice è pubblico

Ho pubblicato tutto su GitHub: codice sorgente, workflow N8N originale e il prompt iniziale che ho passato a Gemini CLI.

👉 github.com/b0sh-net/VideoToMemo

Se vuoi replicare l’esperimento o adattarlo a un tuo caso d’uso, tutto quello che ti serve è lì. Sono curioso di sapere se anche voi avete fatto ragionamenti simili su N8N o su altri strumenti di automazione visuale — scrivetemi nei commenti.

Phone-whisper: trascrizione audio offline su Android con sherpa-onnx

Se hai mai avuto bisogno di trascrivere una nota vocale, un’intervista o un audio WhatsApp direttamente sul tuo smartphone — senza mandare nulla in cloud, senza abbonamenti, senza privacy violata — allora questo progetto fa per te.

phone-whisper è un’app Android open source che ho sviluppato a partire da un fork di un progetto esistente, riprogettandola per fare una cosa sola ma fatta bene: trascrivere file audio condivisi direttamente sul dispositivo, in modo completamente locale.

Da dove nasce il progetto

Il punto di partenza è stato un progetto open source che sfruttava il riconoscimento vocale via microfono. L’idea di base mi piaceva, ma quello che mi serviva era diverso: volevo poter condividere un file audio da qualsiasi app — WhatsApp, Files, un registratore vocale — e ottenere la trascrizione in pochi secondi, tutto offline.

Ho quindi forkato il progetto e ho iniziato ad adattarlo, usando strumenti di intelligenza artificiale come Gemini CLI e Qwen Code per accelerare il refactoring e la riscrittura delle funzionalità principali. L’AI è stata preziosa per navigare una codebase che non conoscevo a fondo e per generare rapidamente le modifiche necessarie all’integrazione con il sistema di condivisione di Android.

Il debugging: quando la trascrizione locale non funzionava

Qui le cose si sono fatte interessanti. Il sistema di trascrizione locale del progetto originale non funzionava in modo affidabile — o meglio, non funzionava affatto nel mio caso. Dopo varie sessioni di debug, ho capito che la soluzione più stabile era integrare direttamente sherpa-onnx, una libreria di inferenza vocale offline estremamente performante, sviluppata dal team k2-fsa.

Il problema? Non potevo semplicemente aggiungere la dipendenza tramite Gradle come si farebbe normalmente. Ho dovuto includere la libreria direttamente come file .aar all’interno del progetto, per garantire compatibilità e controllo sulla versione esatta utilizzata.

E proprio le versioni sono state un altro grattacapo: l’ultima release di sherpa-onnx al momento dello sviluppo (la v1.12.39) aveva un’interfaccia pubblica diversa rispetto a quella pensata per il progetto originale. Questo ha richiesto ulteriori modifiche ai metodi di comunicazione tra i componenti, ma alla fine tutto ha trovato il suo posto.

Come funziona oggi

La release 0.4.4 è stabile e funzionante. Il flusso d’uso è semplice:

  1. Condividi un file audio da qualsiasi app verso phone-whisper
  2. L’app avvia la trascrizione in locale, senza connessione internet
  3. Ottieni il testo trascritto direttamente sul dispositivo

Per ottenere i migliori risultati con audio in italiano, consiglio di utilizzare il modello Parakeet 0.6B: offre un ottimo equilibrio tra qualità della trascrizione e dimensioni del modello.

Una cosa importante sull’installazione del modello

Il primo avvio richiede il download e l’installazione del modello linguistico, che può richiedere qualche minuto. Non interrompere il processo: farlo potrebbe corrompere l’installazione e rendere l’app non funzionante. Se dovesse succedere, è necessario cancellare i dati dell’applicazione dalle impostazioni di Android per poter ripetere l’installazione da capo.

phone-whisper nasce da un’esigenza reale, da un po’ di debugging ostinato e dall’aiuto — sempre più indispensabile — degli strumenti AI per muoversi velocemente in territorio inesplorato. È un progetto piccolo, ma funziona, è privato by design e gira interamente sul tuo telefono.

Ho costruito un’app per l’esame VDS in una giornata – usando Qwen 3.6 Plus gratis su OpenRouter

Continua la serie “Usiamo Claude Code a costo zero”, e questa volta ho unito la programmazione a un’altra mia passione: il volo.

L’Aero Club d’Italia (AECI) mette a disposizione un’applicazione desktop per simulare l’esame di conseguimento dell’attestato VDS (Volo da Diporto o Sportivo). Utile, certo – ma decisamente più comodo avere qualcosa in tasca, da usare anche lontano dalla scrivania. Non a caso esistono già alcune app per smartphone, tutte però a pagamento.

Ho voluto quindi fare un esperimento: quanto tempo ci vuole per replicare le funzionalità dell’app di AECI in formato mobile, usando un modello AI gratuito come strumento di sviluppo?

Il risultato

In circa una giornata di lavoro ho ottenuto un prototipo sostanzialmente funzionante. Lo strumento usato? Qwen 3 Plus, recentemente disponibile gratuitamente su OpenRouter, abbinato a Claude Code.

La qualità del modello è evidente: rispetto a Nemotron 3 Super rappresenta un netto passo avanti in termini di comprensione del contesto e qualità del codice generato. Poterlo usare gratuitamente sembra quasi troppo bello per essere vero – e probabilmente questa finestra non durerà a lungo. Consiglio di sfruttarla finché c’è.

Prova l’app (è open source)

Il codice è disponibile su GitHub: github.com/b0sh-net/vdsexamapp

Chiunque voglia provarla, migliorarla o creare opere derivate è il benvenuto. Il progetto è aperto a contributi e modifiche di ogni tipo.

« Articoli meno recenti

© 2026 b0sh.net

Tema di Anders Noren — Su ↑