Proudly debugging the system since 1981

Tag: AI locale

RustingStrata: raddoppiare le prestazioni dell’AI locale con una RTX 3060

Qualche settimana fa avevo raccontato la mia esperienza con Strata, un progetto che mi aveva incuriosito per la possibilità di utilizzare modelli AI di grandi dimensioni su un normale PC, senza ricorrere a servizi cloud.

L’esperimento era stato positivo: con una NVIDIA RTX 3060 da 12 GB ero riuscito a utilizzare un modello con un contesto molto ampio, ottenendo prestazioni interessanti per una configurazione hardware consumer.

Recentemente mi sono imbattuto in RustingStrata, un progetto che affronta lo stesso problema con un’implementazione completamente diversa: un motore di inferenza scritto in Rust, progettato per sfruttare CPU e GPU in modo ibrido.

La curiosità era inevitabile: quanto poteva cambiare rispetto a Strata?

RustingStrata: un motore di inferenza scritto in Rust

RustingStrata è un progetto open source che permette di eseguire modelli GGUF sfruttando contemporaneamente CPU e GPU.

L’aspetto interessante è la gestione dei modelli Mixture of Experts (MoE). Non tutti i parametri di questi modelli vengono utilizzati per elaborare ogni token: RustingStrata sfrutta questa caratteristica mantenendo sulla GPU gli esperti che riesce a ospitare nella VRAM e gestendo gli altri attraverso la memoria di sistema.

Il posizionamento degli esperti viene inoltre adattato dinamicamente in base al loro effettivo utilizzo.

Il risultato è la possibilità di utilizzare modelli molto più grandi della memoria video disponibile, senza dover rinunciare completamente all’accelerazione GPU.

Il progetto supporta sia CUDA sia Vulkan. Nel mio caso, naturalmente, ho scelto CUDA.

Installazione: qualche ostacolo con CUDA

L’installazione su Windows è abbastanza semplice: il progetto è scritto in Rust e può essere compilato direttamente dai sorgenti con Cargo.

cargo build --release

Il primo problema è arrivato proprio con CUDA.

Sul PC avevo già installato il CUDA Toolkit 12.8, ma RustingStrata utilizza cudarc e richiede le librerie NVRTC della versione CUDA 13. Inizialmente il motore non riusciva a inizializzare CUDA e ripiegava automaticamente su Vulkan.

La soluzione è stata scaricare dal sito NVIDIA il pacchetto standalone NVRTC 13.1, senza dover sostituire l’intera installazione del CUDA Toolkit.

Ho estratto le DLL in:

C:\AI\CUDA\13.1

E ho aggiunto la directory al PATH prima di avviare il programma:

set "PATH=C:\AI\CUDA\13.1;%PATH%"

Le librerie necessarie erano nvrtc64_130_0.dll e nvrtc-builtins64_131.dll.

A quel punto CUDA è stato inizializzato correttamente e i kernel sono stati compilati per l’architettura sm_86 della RTX 3060.

Il problema della calibrazione

Superato il problema CUDA, mi sono imbattuto in un secondo ostacolo.

RustingStrata dispone di un comando calibrate che misura le prestazioni del sistema e individua alcuni parametri ottimali per l’esecuzione del modello.

La prima esecuzione terminava però con un errore di copia in memoria GPU:

Error: htod: 4128768 bytes at 77660160 into 80216064

Ho provato a modificare il contesto, il margine di VRAM e il formato della KV cache, senza successo.

Analizzando il codice sorgente ho individuato una possibile causa: durante la calibrazione il modello veniva caricato con tre draft MTP, una funzionalità utilizzata per la speculative decoding.

Ho quindi modificato temporaneamente il parametro nella chiamata a GpuModel::load, passando da 3 a 0, disabilitando MTP durante la calibrazione.

Dopo aver ricompilato il progetto, calibrate è finalmente terminato correttamente, generando il file JSON con i parametri misurati.

Non ho approfondito ulteriormente la causa dell’errore, ma il workaround è stato sufficiente per completare la configurazione.

Il benchmark: 121K token, stesso hardware e stesso modello

Arriviamo alla parte più interessante.

Per confrontare i due motori ho utilizzato lo stesso test già eseguito con Strata: un prompt di circa 121.000 token, costruito sul classico scenario “Ago in un pagliaio”.

L’obiettivo è verificare se il modello riesce a recuperare informazioni specifiche nascoste all’interno di una grande quantità di testo.

Per rendere il confronto significativo ho mantenuto invariati:

  • Hardware: AMD Ryzen 5 9600X, 32 GB DDR5 e NVIDIA RTX 3060 da 12 GB.
  • Modello: Ornith-1.5-35B-A3B-IQ4_XS.gguf.
  • Prompt e domande.

I risultati sono stati decisamente interessanti.

MetricaStrataRustingStrata
Prompt121K token121K token
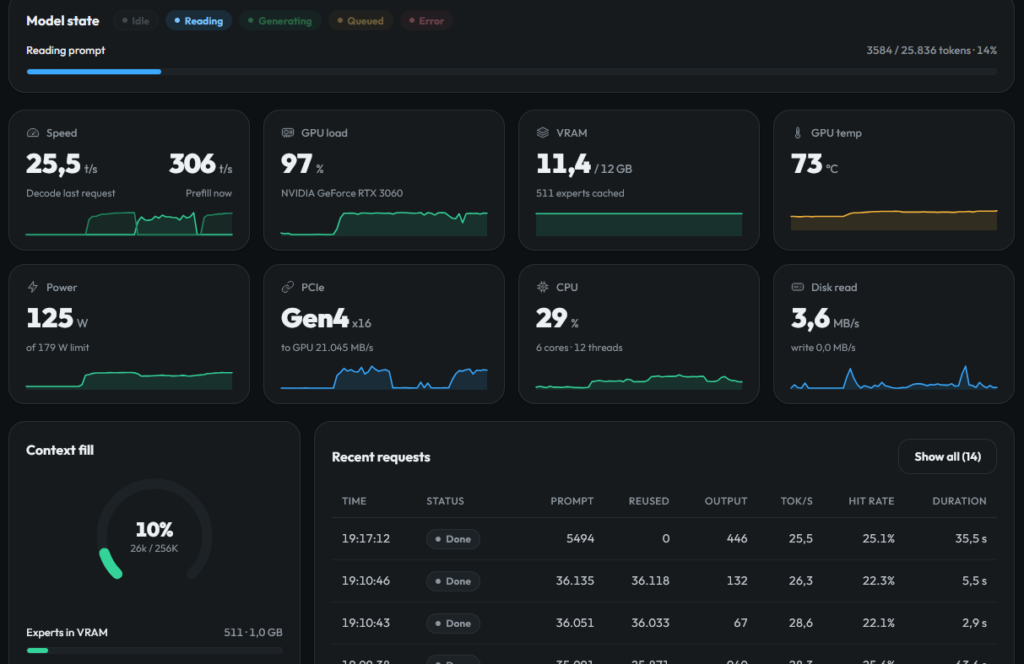
Prefill340 tok/s730 tok/s
Generazione~30 tok/s~30 tok/s
Risposte corretteSìSì

La differenza più evidente riguarda il prefill, cioè la fase in cui il motore legge ed elabora il prompt prima di iniziare a generare la risposta.

RustingStrata raggiunge circa 730 token al secondo contro i 340 di Strata: più del doppio, con un incremento di circa il 115%.

La velocità di generazione è invece sostanzialmente identica, intorno ai 30 token al secondo per entrambi i motori.

Non attribuirei però particolare significato a quest’ultimo dato: il test “Ago in un pagliaio” è pensato soprattutto per verificare la capacità di recuperare informazioni da un contesto molto esteso. I pochi token generati non permettono di valutare in modo significativo le prestazioni di decoding.

Un altro elemento importante è che entrambi i motori hanno fornito le risposte corrette. Non ho quindi osservato, in questo test, un peggioramento della capacità di recupero delle informazioni passando a RustingStrata.

Considerazioni finali

Il risultato mi ha sorpreso positivamente.

Il dato che considero più significativo non è tanto la velocità di generazione, rimasta sostanzialmente invariata, quanto il tempo necessario per elaborare il contesto.

Quando si utilizza un coding agent, oppure si sottopone al modello una grande quantità di codice, documentazione o cronologia delle conversazioni, il prefill può rappresentare una parte importante del tempo di attesa.

Passare da 340 a 730 token al secondo significa ridurre sensibilmente questa attesa.

Naturalmente un singolo test non è sufficiente per stabilire che RustingStrata sia sempre più veloce di Strata in qualsiasi scenario. Servirebbero ulteriori benchmark con prompt di dimensioni differenti.

Ma il risultato ottenuto sulla mia macchina è concreto: stesso modello, stesso prompt, stesso hardware e risposte corrette da entrambi i motori.

Per il momento RustingStrata ha conquistato il posto di motore principale per le mie prove di AI locale.

E pensare che tutto questo gira su una RTX 3060 da 12 GB!

Il coding locale continua a diventare sempre più interessante.
Strata: coding locale con una RTX 3060

Un modello da circa 180 miliardi di parametri, sul mio PC, con una RTX 3060 da 12 GB. È questa la promessa che mi ha incuriosito e mi ha spinto a provare Strata: dopo una prima sessione di coding, la sensazione è di aver fatto un passo avanti concreto rispetto ai modelli che usavo finora in locale.

Non è soltanto una questione di riuscire ad avviare un modello molto grande. Il punto è riuscire a usarlo con velocità accettabili, un contesto ampio e una qualità che lo renda interessante anche per lavorare sul codice.

Che cos’è Strata

Strata è un progetto gratuito e open source che permette di eseguire Qwen3.8-Flash-Next su hardware consumer, distribuendo il lavoro tra GPU, CPU, RAM e SSD. Offre un’interfaccia web e API locali compatibili con OpenAI e Anthropic, così da poter collegare applicazioni e coding agent senza ricorrere a un servizio di inferenza cloud.

Il modello di partenza è notevole: Qwen3.8-Flash-Next conta circa 180 miliardi di parametri complessivi, includendo le componenti n-gram e quelle dedicate alla predizione di più token. Non è però un modello denso di quelle dimensioni: adotta un’architettura Mixture of Experts, che attiva solo una parte degli esperti per ciascun token. Il contesto nativo arriva a 262.144 token.

Strata sfrutta queste caratteristiche per rendere possibile l’esecuzione su un normale PC. La GPU mantiene gli esperti usati più frequentemente, mentre RAM e CPU gestiscono il resto; una grande tabella di lookup risiede invece sull’SSD. Non serve, quindi, far entrare tutto il modello nella VRAM.

I requisiti dichiarati partono da una GPU supportata con almeno 12 GB di VRAM, 32 GB di RAM e circa 80 GB liberi su disco, preferibilmente SSD. Il progetto supporta Windows e Linux e propone diverse varianti del modello in funzione della memoria disponibile.

Il mio PC e il modello

Ho provato Strata su questa configurazione:

ComponenteHardware
CPUAMD Ryzen 5 9600X
RAM32 GB DDR5
ArchiviazioneSSD PCIe Gen4
GPUNVIDIA RTX 3060, 12 GB di VRAM
Modello selezionatoCoder

Con 32 GB di RAM ho scelto la variante Coder, che è anche quella consigliata dal progetto per questa quantità di memoria.

La versione Coder di ISTA-DASLab non è semplicemente una quantizzazione del modello completo: combina la riduzione di precisione dei pesi con il pruning, cioè la rimozione di metà degli esperti. La selezione privilegia le capacità legate al codice e all’uso agentico degli strumenti, accettando una perdita maggiore in altri ambiti.

Il dato interessante è quanto riesca a conservare nei benchmark dichiarati dagli autori: il 91,3% del punteggio del modello originale su SWE-bench Verified e il 98,7% su LiveCodeBench v6. Quindi “oltre il 90% delle capacità” va inteso in relazione a questi test di coding, non come una misura universale dell’intelligenza del modello.

Le prestazioni sul campo

Sul mio PC ho osservato circa 300 token al secondo in prefill, cioè nella lettura del prompt, e circa 30 token al secondo in generazione. Per il modello e l’hardware in gioco, considero queste prestazioni molto buone.

A fine prova, le statistiche erano queste:

MetricaRisultato
Richieste complessive75
Token di prompt elaborati284.200
Velocità media di prefill286 token/s
Token riutilizzati dalla cache4.335.358
Token generati68.865
Velocità media di generazione30,6 token/s

Sono numeri raccolti durante l’utilizzo, non un benchmark controllato. Descrivono però bene la mia esperienza: la velocità di generazione è sufficiente a rendere il modello concretamente utilizzabile, non soltanto interessante da provare.

La cache è uno degli aspetti che mi hanno colpito di più. Nel corso delle 75 richieste, oltre 4,3 milioni di token sono stati riutilizzati, contro circa 284 mila token effettivamente elaborati in prefill.

Dal punto di vista del tempo di rilettura, quei token recuperati dalla cache sono stati praticamente “gratis”. Nella mia sessione questo ha fatto una differenza importante: il contesto poteva crescere senza dover pagare ogni volta il costo di elaborarlo nuovamente per intero.

Coding con OpenCode

Per andare oltre la semplice chat, ho fatto una breve sessione di coding usando OpenCode come harness.

La compressione un po’ si percepisce. Non ho avuto la sensazione di usare il modello originale senza compromessi, e sarebbe prematuro trarre conclusioni definitive da una prova così breve. Detto questo, nella mia esperienza è andato meglio di qualsiasi altro modello locale che abbia usato finora.

Il riferimento precedente era Qwen 3.6 31B, insieme ai relativi fine-tuning e alle diverse quantizzazioni. Rispetto a quella base, Strata con il modello Coder mi è sembrato un netto passo avanti.

Anche il contesto merita attenzione: nella mia configurazione avevo a disposizione 256K token e durante la prova sono arrivato a usarne circa 100K. Non ho quindi verificato il comportamento al limite massimo, ma non ho dovuto ridurre drasticamente la finestra di contesto per rendere il modello utilizzabile sul mio hardware.

Come riferimento cloud uso molto, ultimamente, DeepSeek 4.1 Flash. È il livello di qualità che avevo in mente avvicinandomi a questa prova, ma non ho svolto un confronto diretto e controllato: non considero quindi questa sessione una dimostrazione di equivalenza tra i due.

Un passo avanti concreto

La parte più interessante di questa esperienza è l’insieme: qualità del codice, circa 30 token al secondo in generazione, un contesto ampio e una cache che nella pratica funziona molto bene.

La compressione comporta dei compromessi, e la mia resta una prima prova. Ma il risultato non è più soltanto “un modello enorme che in qualche modo gira sul PC”: è un modello che ho potuto usare dentro un coding agent, con prestazioni convincenti, su una macchina con 32 GB di RAM e una RTX 3060 da 12 GB.

Per il mio utilizzo, Strata rappresenta un salto concreto rispetto a Qwen 3.6 31B e alle varianti che usavo prima. Non significa che abbia già sostituito i modelli cloud nel mio flusso di lavoro; significa però che il coding locale è diventato un’alternativa molto più credibile.

OpenHuman: promesse grandi, prova sul campo deludente

Ho provato OpenHuman con l’idea di testare un progetto che, sulla carta, sembra voler portare gli agenti AI locali un passo più in là. Il risultato, però, è stato molto meno entusiasmante del racconto che accompagna il repository: installazione rapida, avvio instabile, integrazioni confuse e, alla fine, nessuna esperienza davvero solida da portare a casa.

La prova più interessante non è stata nemmeno il primo avvio fallito su Fedora in VM, ma il confronto tra ambienti diversi. Su una macchina fisica Windows con GPU, OpenHuman parte; appena si entra nel flusso di configurazione, però, emergono subito domande poco rassicuranti: login cloud richiesto, collegamento Gmail mediato da un servizio terzo, e una catena di dipendenze che rende il concetto di “locale” molto più sfumato di quanto il marketing lasci intendere.

Un progetto che promette molto

OpenHuman si presenta come un assistente personale AI locale, capace di integrarsi con servizi esterni, gestire memoria e collegarsi a modelli LLM sia in locale sia in cloud. Il pitch è forte: un agente “human-centric”, pronto a conoscersi in pochi minuti e a diventare parte del flusso di lavoro quotidiano.

Ed è proprio qui che nasce il problema. Più la promessa è ambiziosa, più ci si aspetta che il setup sia semplice, trasparente e affidabile. Invece la mia esperienza è stata l’opposto: ogni passo sembrava introdurre un nuovo livello di complessità, spesso non spiegato bene all’utente.

Fedora in VM: crash, errori e packaging fragile

Il primo test è stato su Fedora in macchina virtuale. Qui OpenHuman ha mostrato subito il suo lato più fragile. L’installazione è partita velocemente, ma all’avvio il programma non è riuscito a completare il bootstrap in modo stabile. I log hanno iniziato a restituire errori diversi a ogni tentativo, e questo è già di per sé un pessimo segnale.

Tra i messaggi più significativi c’erano:

textVMware: No 3D enabled

e soprattutto:

textError initializing NSS with a persistent database
version `NSSUTIL_3.108' not found
FATAL: nss_error=-5925

In pratica, il pacchetto distribuiva librerie incompatibili con quelle presenti sul sistema. Il risultato non era solo un crash, ma un crash dovuto a un conflitto abbastanza banale da sembrare quasi un errore di packaging elementare. Ho provato anche a forzare l’esecuzione con estrazione manuale dell’AppImage, variabili ambientali diverse e disabilitazione della GPU, ma senza successo.

A quel punto il problema non era più il singolo workaround: era il fatto che il software, su una configurazione abbastanza comune come Fedora in VM, falliva in modo ripetuto e poco affidabile.

Windows con GPU: parte, ma non convince

Su una macchina fisica Windows con GPU, OpenHuman si installa e si avvia. Questo però non ha risolto il mio giudizio, anzi lo ha reso più netto. La prima sorpresa è stata la richiesta di un login cloud già al primo avvio, cosa che stride parecchio con l’immagine di applicazione locale e privacy-oriented.

Poi è arrivata la richiesta di collegare Gmail attraverso un target chiamato Composio. Il problema non è solo tecnico, ma concettuale: non viene spiegato chiaramente perché un software che si presenta come locale debba passare da una terza parte esterna per accedere alle mail. Per me questa è una soglia di fiducia importante, e senza una spiegazione trasparente il risultato è un semplice “no”.

Skip sì, utilità poca

C’è un pulsante tipo “skip for now”, quindi in teoria si può andare avanti anche senza concedere tutto subito. In pratica bisogna insistere un po’, ma alla fine si entra davvero nell’app.

Il punto è un altro: se rifiuti di dare accesso a terze parti, OpenHuman resta davvero utile? Questa è la domanda centrale. Perché le funzioni più interessanti sembrano vivere proprio nel punto di incontro tra app locale, account cloud e servizi esterni. Se togli quella parte, resta un guscio molto meno significativo rispetto a quanto il progetto promette.

Ollama, Open WebUI e OpenRouter: altre prove fallite

A questo punto ho provato a portare il tutto sul terreno più favorevole possibile: accesso LLM locale via Ollama, poi Open WebUI come eventuale router/proxy, e infine OpenRouter per testare anche una strada cloud.

Il risultato è stato sempre negativo. Con Ollama non arrivava nessuna risposta in chat e ollama ps non mostrava modelli caricati. Con Open WebUI, usando impostazioni che con altre applicazioni funzionano correttamente, il backend restava silenzioso. Con OpenRouter non è cambiato nulla: le richieste non apparivano neppure nei log.

Questo è stato probabilmente il segnale più chiaro di tutti. Non si tratta di un singolo provider da sistemare o di una configurazione da rifinire. Il problema sembra stare nel modo in cui OpenHuman orchestra il tutto: integrazione, routing, backend, richieste. Se la pipeline non produce neppure tracce nei log, la sensazione è che la superficie sia più avanzata della sostanza.

Perché tante stelline?

La domanda, a questo punto, viene naturale: come fa un software così approssimativo a ottenere tante stelline su GitHub?

La risposta probabilmente non è misteriosa: oggi molti progetti AI vendono prima l’idea e solo dopo il prodotto. Bastano un README convincente, una roadmap ambiziosa, qualche schermata accattivante e un paio di video ben fatti per generare entusiasmo. In molti casi il pubblico non prova davvero il software in scenari normali, oppure lo fa per pochi minuti in condizioni ideali.

OpenHuman mi sembra rientrare proprio in questa categoria: molto forte sul piano narrativo, molto più debole nella prova concreta. E quando il marketing corre parecchio avanti rispetto alla maturità reale del codice, le stelline diventano un indicatore meno affidabile di quanto sembri.

Verdetto attuale

Per ora la valutazione è negativa. Non perché il progetto sia “senza idea”, ma perché l’idea è venduta come se fosse già matura, mentre nella pratica l’esperienza è fragile, poco trasparente e inadatta a un uso sereno.

Il test su Fedora in VM è fallito. Il test su Windows è partito ma ha introdotto dubbi sostanziali sulla privacy e sulle dipendenze cloud. I tentativi con Ollama, Open WebUI e OpenRouter non hanno migliorato il quadro. Il risultato complessivo è un software che promette molto, ma che al momento convince poco.

Disinstallerò OpenHuman e disconnetterò l’account. Per ora, almeno nel mio uso, resta un progetto interessante da osservare, ma non ancora uno strumento davvero affidabile.

© 2026 b0sh.net

Tema di Anders Noren — Su ↑