Proudly debugging the system since 1981

Tag: OpenCode

Ho provato REA su YI Home: due ore, 332 milioni di token e un MVP

C’è un momento in cui un progetto di reverse engineering smette di essere un progetto e diventa un tarlo. YI Home, per me, è stato esattamente questo.

Nel 2019 avevo provato a capire come l’app delle telecamere parlasse con il cloud. Avevo intercettato il traffico HTTPS, individuato l’endpoint di login, capito che la password non era semplicemente hashata ma passava per un HMAC-SHA256 con un segreto. Poi mi ero fermato. Quel segreto non si trovava, il protocollo era più intricato del previsto e il tempo necessario per andare avanti non era compatibile con un hobby. La serie di post si chiudeva con una battuta: “Qualcuno ha qualche PetaFLOP da prestarmi?”

Qualche anno dopo la situazione era peggiorata: l’app funzionava, ma era diventata un condominio di SDK pubblicitari. Avevo ricominciato a guardarla con l’idea di sostituirla, senza però ricadere nella trappola di un progetto infinito.

Cos’è REA

Negli ultimi mesi REA è circolato molto. Di solito, quando uno strumento fa questo rumore, mi viene il sospetto che sia più spettacolare che utile. Stavolta ho voluto verificare sul campo.

REA, Reverse Engineer Anything, è un MCP: in pratica dà al coding agent una cassetta di attrezzi per guardare dentro un programma. Non si limita a generare codice intorno a un’idea, ma legge l’artefatto, segue le chiamate, recupera funzioni e dati, e restituisce all’agente il materiale su cui ragionare. È il tipo di strumento che cambia il modo in cui poni le domande: non “scrivimi un’app”, ma “come funziona questo pezzo?” e poi “ricostruiscilo”.

Il punto di partenza era ovvio: https://rea.tools/.

La prova

Ho preso l’APK di YI Home 6.9.9 e l’ho messo davanti all’agente. Non è un’app Java con un paio di REST: è un runtime ibrido con dieci DEX, un modulo Flutter compilato, un bundle H5 e lo stack nativo TUTK per il P2P. JADX ha tirato fuori circa 31.864 classi, con 385 errori di decompilazione: non esattamente il terreno ideale per un lavoretto serale.

Ed è qui che REA ha fatto la differenza. L’agente ha potuto seguire il flusso di login, ricostruire la firma delle richieste e individuare la chiave hardcoded usata per l’HMAC della password. La password è un HMAC-SHA256, le chiamate sono firmate con HMAC-SHA1 su token e token_secret, e i media degli eventi sono cifrati. Dettagli che, messi insieme, spiegano perché il tentativo manuale di anni prima si fosse arenato.

Il bello è che non ho dovuto chiedere tutto in un colpo. Ho lavorato a piccoli passi: prima la struttura dell’artefatto, poi il login, poi la lista camere, poi gli eventi. Ogni risposta diventava la base per la domanda successiva. È un modo di lavorare molto più simile a un’indagine che a un prompt unico.

Cosa è uscito

In circa due ore è nato un MVP funzionante: una web app Angular che usa lo stesso account e lo stesso backend dell’app Android.

  • login reale e selezione della regione;
  • lista camere, dettaglio e stato online;
  • timeline eventi con thumbnail;
  • riproduzione dei video evento tramite proxy HLS;
  • profilo e impostazioni principali;
  • nessuna pubblicità, nessun billing, nessun paywall aggiunto lato client.

Ho fatto la prova sul mio account, senza toccare impostazioni, senza eliminare camere e senza modificare nulla. Sono state rilevate quattro telecamere, circa 116 eventi negli ultimi trenta giorni, e i video degli eventi sono stati riprodotti correttamente. La sezione Cloud, per il mio account, restituiva zero clip: non un errore del client, semplicemente il backend non aveva registrazioni da mostrare.

La prima messa online è finita in un 503 per un path sbagliato nel reverse proxy. Corretto il path, la web app è andata su senza altre sorprese. Per ora vive qui: https://yiweb.b0sh.net/

I numeri

Alla fine il conto era questo:

  • circa due ore di lavoro;
  • 332 milioni di token;
  • circa 3 dollari di costo.

Il dato sui token fa più scena che altro: è il volume complessivo della sessione, non la quantità di codice scritto. Buona parte è contesto riletto mentre il lavoro andava avanti. Il costo è quello che ho visto io, con il provider che uso; non è un preventivo universale.

Cosa non è

Non è un clone completo dell’app. Il live P2P TUTK/Kami non è replicabile da browser senza un bridge nativo, quindi la web app è una console cloud, non un sostituto totale dell’app mobile. Non ho implementato binding delle camere, firmware, push, acquisti o abbonamenti. Sono limiti espliciti, non finte implementazioni.

E non è nemmeno magia. REA non “capisce” l’app al posto tuo: dà all’agente gli occhi per guardarla. La parte di verifica resta fondamentale. Ho controllato le risposte, provato il login, guardato i video e sistemato il deploy. Lo strumento accorcia il percorso, non elimina il giudizio.

La lezione

Per me la lezione non è “l’AI fa il reverse engineering”. È che il costo di ingresso per certi progetti è crollato.

Prima YI Home era un progetto che richiedeva giorni o settimane per ottenere una singola risposta, e quindi restava archiviato. Oggi ho potuto riaprirlo, capire abbastanza per costruire qualcosa di utile e metterlo online in una sera. Non è poco.

Non so se REA sostituirà il reverse engineering tradizionale. Per me ha già fatto una cosa più interessante: ha reso di nuovo affrontabile un progetto che avevo smesso di considerare tale.
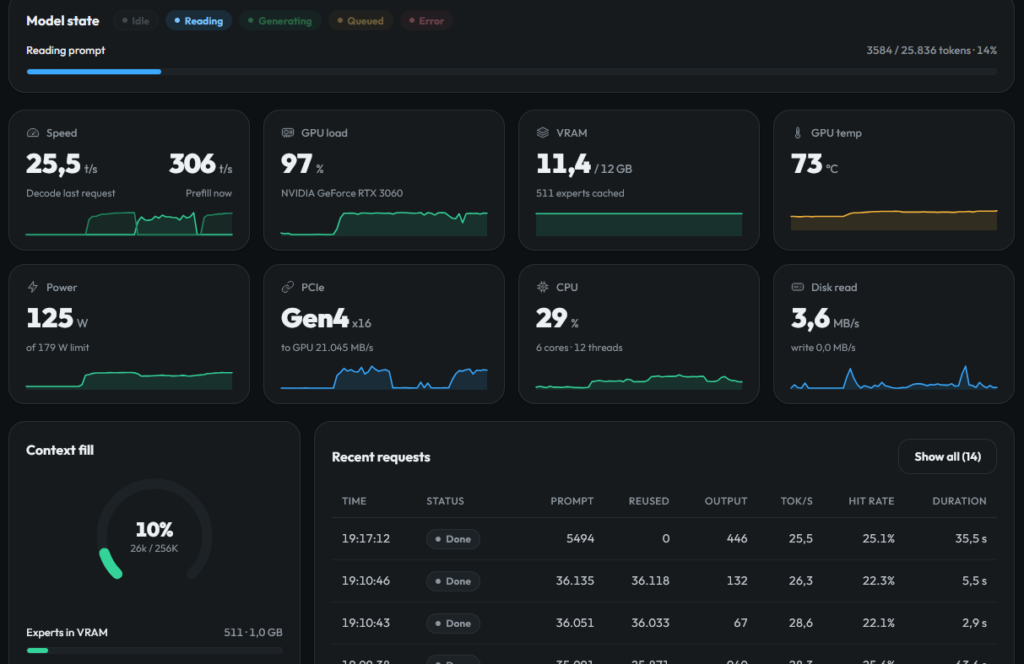
Strata: coding locale con una RTX 3060

Un modello da circa 180 miliardi di parametri, sul mio PC, con una RTX 3060 da 12 GB. È questa la promessa che mi ha incuriosito e mi ha spinto a provare Strata: dopo una prima sessione di coding, la sensazione è di aver fatto un passo avanti concreto rispetto ai modelli che usavo finora in locale.

Non è soltanto una questione di riuscire ad avviare un modello molto grande. Il punto è riuscire a usarlo con velocità accettabili, un contesto ampio e una qualità che lo renda interessante anche per lavorare sul codice.

Che cos’è Strata

Strata è un progetto gratuito e open source che permette di eseguire Qwen3.8-Flash-Next su hardware consumer, distribuendo il lavoro tra GPU, CPU, RAM e SSD. Offre un’interfaccia web e API locali compatibili con OpenAI e Anthropic, così da poter collegare applicazioni e coding agent senza ricorrere a un servizio di inferenza cloud.

Il modello di partenza è notevole: Qwen3.8-Flash-Next conta circa 180 miliardi di parametri complessivi, includendo le componenti n-gram e quelle dedicate alla predizione di più token. Non è però un modello denso di quelle dimensioni: adotta un’architettura Mixture of Experts, che attiva solo una parte degli esperti per ciascun token. Il contesto nativo arriva a 262.144 token.

Strata sfrutta queste caratteristiche per rendere possibile l’esecuzione su un normale PC. La GPU mantiene gli esperti usati più frequentemente, mentre RAM e CPU gestiscono il resto; una grande tabella di lookup risiede invece sull’SSD. Non serve, quindi, far entrare tutto il modello nella VRAM.

I requisiti dichiarati partono da una GPU supportata con almeno 12 GB di VRAM, 32 GB di RAM e circa 80 GB liberi su disco, preferibilmente SSD. Il progetto supporta Windows e Linux e propone diverse varianti del modello in funzione della memoria disponibile.

Il mio PC e il modello

Ho provato Strata su questa configurazione:

ComponenteHardware
CPUAMD Ryzen 5 9600X
RAM32 GB DDR5
ArchiviazioneSSD PCIe Gen4
GPUNVIDIA RTX 3060, 12 GB di VRAM
Modello selezionatoCoder

Con 32 GB di RAM ho scelto la variante Coder, che è anche quella consigliata dal progetto per questa quantità di memoria.

La versione Coder di ISTA-DASLab non è semplicemente una quantizzazione del modello completo: combina la riduzione di precisione dei pesi con il pruning, cioè la rimozione di metà degli esperti. La selezione privilegia le capacità legate al codice e all’uso agentico degli strumenti, accettando una perdita maggiore in altri ambiti.

Il dato interessante è quanto riesca a conservare nei benchmark dichiarati dagli autori: il 91,3% del punteggio del modello originale su SWE-bench Verified e il 98,7% su LiveCodeBench v6. Quindi “oltre il 90% delle capacità” va inteso in relazione a questi test di coding, non come una misura universale dell’intelligenza del modello.

Le prestazioni sul campo

Sul mio PC ho osservato circa 300 token al secondo in prefill, cioè nella lettura del prompt, e circa 30 token al secondo in generazione. Per il modello e l’hardware in gioco, considero queste prestazioni molto buone.

A fine prova, le statistiche erano queste:

MetricaRisultato
Richieste complessive75
Token di prompt elaborati284.200
Velocità media di prefill286 token/s
Token riutilizzati dalla cache4.335.358
Token generati68.865
Velocità media di generazione30,6 token/s

Sono numeri raccolti durante l’utilizzo, non un benchmark controllato. Descrivono però bene la mia esperienza: la velocità di generazione è sufficiente a rendere il modello concretamente utilizzabile, non soltanto interessante da provare.

La cache è uno degli aspetti che mi hanno colpito di più. Nel corso delle 75 richieste, oltre 4,3 milioni di token sono stati riutilizzati, contro circa 284 mila token effettivamente elaborati in prefill.

Dal punto di vista del tempo di rilettura, quei token recuperati dalla cache sono stati praticamente “gratis”. Nella mia sessione questo ha fatto una differenza importante: il contesto poteva crescere senza dover pagare ogni volta il costo di elaborarlo nuovamente per intero.

Coding con OpenCode

Per andare oltre la semplice chat, ho fatto una breve sessione di coding usando OpenCode come harness.

La compressione un po’ si percepisce. Non ho avuto la sensazione di usare il modello originale senza compromessi, e sarebbe prematuro trarre conclusioni definitive da una prova così breve. Detto questo, nella mia esperienza è andato meglio di qualsiasi altro modello locale che abbia usato finora.

Il riferimento precedente era Qwen 3.6 31B, insieme ai relativi fine-tuning e alle diverse quantizzazioni. Rispetto a quella base, Strata con il modello Coder mi è sembrato un netto passo avanti.

Anche il contesto merita attenzione: nella mia configurazione avevo a disposizione 256K token e durante la prova sono arrivato a usarne circa 100K. Non ho quindi verificato il comportamento al limite massimo, ma non ho dovuto ridurre drasticamente la finestra di contesto per rendere il modello utilizzabile sul mio hardware.

Come riferimento cloud uso molto, ultimamente, DeepSeek 4.1 Flash. È il livello di qualità che avevo in mente avvicinandomi a questa prova, ma non ho svolto un confronto diretto e controllato: non considero quindi questa sessione una dimostrazione di equivalenza tra i due.

Un passo avanti concreto

La parte più interessante di questa esperienza è l’insieme: qualità del codice, circa 30 token al secondo in generazione, un contesto ampio e una cache che nella pratica funziona molto bene.

La compressione comporta dei compromessi, e la mia resta una prima prova. Ma il risultato non è più soltanto “un modello enorme che in qualche modo gira sul PC”: è un modello che ho potuto usare dentro un coding agent, con prestazioni convincenti, su una macchina con 32 GB di RAM e una RTX 3060 da 12 GB.

Per il mio utilizzo, Strata rappresenta un salto concreto rispetto a Qwen 3.6 31B e alle varianti che usavo prima. Non significa che abbia già sostituito i modelli cloud nel mio flusso di lavoro; significa però che il coding locale è diventato un’alternativa molto più credibile.

BookmarkFox: resuscitare Delicious con Firefox e un po’ di AI-assisted coding

C’è un momento, per chi naviga il web da abbastanza tempo, in cui capisci che un servizio chiuso non è mai stato davvero sostituito. Per me quel servizio era Delicious.

Chi se lo ricorda sa di cosa parlo: un modo semplice per salvare i segnalibri, taggarli, e condividerli con altri. Quando Delicious ha chiuso i battenti, ho passato anni a provare alternative — estensioni, servizi cloud, note app riadattate — senza trovare niente che replicasse quel flusso naturale: trovo un sito interessante, lo salvo con un click, lo condivido con chi mi segue. Alla fine ho deciso di risolvere il problema alla vecchia maniera: scrivendomi l’alternativa da solo.

È nato così BookmarkFox, un’estensione per Firefox che comunica con un backend web per pubblicare i segnalibri. Niente di rivoluzionario nell’idea, ma è esattamente quello che mi serviva — e visto che non esisteva, l’ho costruito.

Il problema: nessuna vera alternativa a Delicious

Le opzioni moderne per gestire segnalibri condivisibili sono o troppo pesanti (servizi enterprise di bookmarking/knowledge management) o troppo chiuse in un ecosistema (salvataggi legati a un singolo social o browser). Mancava qualcosa di leggero, personale, e soprattutto self-hosted: un’estensione che facesse una cosa sola, bene, e che mi lasciasse controllo pieno sui dati.

BookmarkFox nasce da questa esigenza precisa: un’estensione Firefox minimale che pubblica i segnalibri su un backend che gestisco io, raggiungibile su bookmarkfox.b0sh.net.

Come ho lavorato: SpecKit invece del solito “vibe coding”

La parte che mi interessa raccontare di più, però, non è il “cosa” ma il “come”. Negli ultimi tempi ho sviluppato diversi progettini con l’aiuto di modelli AI locali o via API, e il pattern tipico è quello del prompt libero seguito da iterazioni a ruota libera. Funziona, ma con progetti che superano una certa complessità il modello perde il filo, e tu perdi tempo a rispiegare il contesto ogni volta.

Per BookmarkFox ho voluto provare un approccio più strutturato, usando GitHub SpecKit insieme a OpenCode. L’idea di SpecKit è semplice ma efficace:

  • Si parte da un prompt utente ad alto livello (l’idea del progetto).
  • SpecKit guida una fase di analisi dettagliata, trasformando l’idea grezza in una specifica vera e propria.
  • C’è una fase di clarification: il sistema pone domande specifiche per chiarire ambiguità prima di scrivere codice, invece di assumere e sbagliare.
  • Solo dopo la specifica viene suddivisa in task ben definiti, ognuno con un perimetro chiaro.

Il vantaggio pratico? Un modello non enorme — nel mio caso DeepSeek V4 Flash, con 250k di contesto — riesce a lavorare bene su singole task senza dover tenere “in mente” tutta l’architettura del progetto contemporaneamente. Ogni task è autoconclusiva, con contesto sufficiente ma non eccessivo. Il risultato è un workflow più prevedibile, meno “allucinazioni” da perdita di contesto, e codice più coerente con l’architettura pensata a monte.

È un cambio di paradigma interessante: non si tratta di usare un modello più potente, ma di strutturare meglio il problema perché anche un modello più leggero possa affrontarlo con efficacia. Per chi lavora con LLM locali o con budget di context window limitati, è una lezione che vale la pena portarsi a casa.

Il risultato

BookmarkFox oggi è operativo:

  • L’estensione è scaricabile dalle release su GitHub.
  • Il backend che gestisce la pubblicazione dei segnalibri è live su bookmarkfox.b0sh.net.
  • Il codice è open source, disponibile per chiunque voglia guardare sotto il cofano, contribuire, o semplicemente farsi un’idea di come è stato strutturato il progetto con SpecKit.

Non è (ancora) Delicious 2.0, ma è già quello che mi serviva: un modo veloce per salvare e condividere i siti interessanti che trovo in giro, senza dipendere da un servizio terzo che può chiudere domani.

Cosa mi porto a casa

Al di là del progetto in sé, l’esperienza con SpecKit mi ha convinto che il futuro dell’AI-assisted coding per progetti non banali passa da qui: meno prompt-e-spera, più analisi-chiarifica-scomponi. È un investimento di tempo iniziale che si ripaga abbondantemente quando il progetto cresce oltre le due-tre funzioni.

Se usi Firefox e ti manca un modo semplice per salvare e condividere segnalibri, dai un’occhiata a BookmarkFox. E se sei curioso di provare tu stesso il workflow SpecKit + LLM locale, è un ottimo punto di partenza per progetti di dimensioni simili.

© 2026 b0sh.net

Tema di Anders Noren — Su ↑