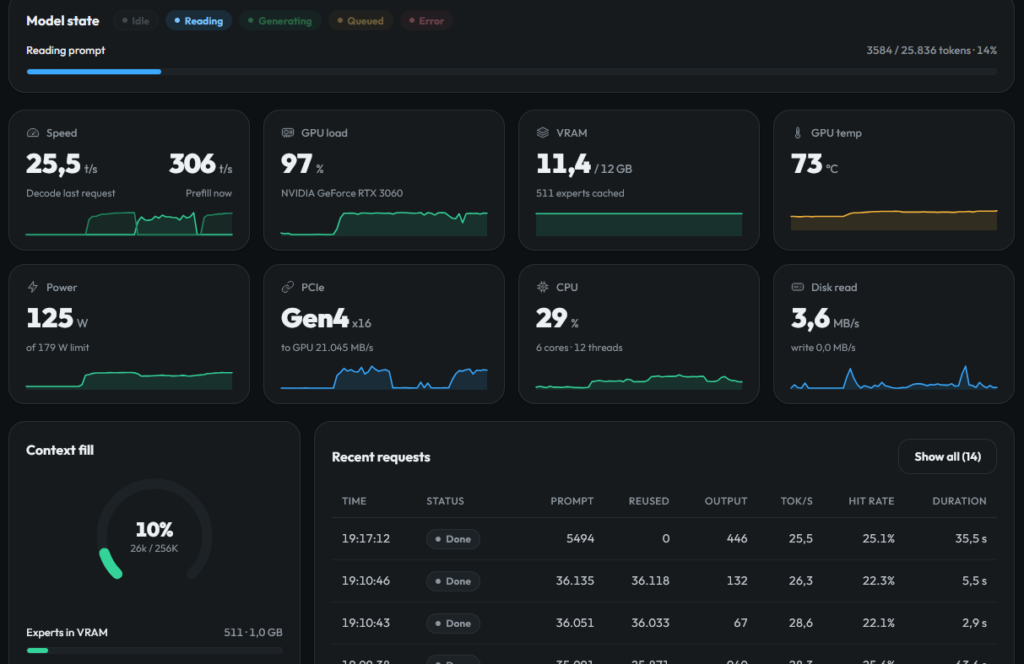
Qualche settimana fa avevo raccontato la mia esperienza con Strata, un progetto che mi aveva incuriosito per la possibilità di utilizzare modelli AI di grandi dimensioni su un normale PC, senza ricorrere a servizi cloud.
L’esperimento era stato positivo: con una NVIDIA RTX 3060 da 12 GB ero riuscito a utilizzare un modello con un contesto molto ampio, ottenendo prestazioni interessanti per una configurazione hardware consumer.
Recentemente mi sono imbattuto in RustingStrata, un progetto che affronta lo stesso problema con un’implementazione completamente diversa: un motore di inferenza scritto in Rust, progettato per sfruttare CPU e GPU in modo ibrido.
La curiosità era inevitabile: quanto poteva cambiare rispetto a Strata?
RustingStrata: un motore di inferenza scritto in Rust
RustingStrata è un progetto open source che permette di eseguire modelli GGUF sfruttando contemporaneamente CPU e GPU.
L’aspetto interessante è la gestione dei modelli Mixture of Experts (MoE). Non tutti i parametri di questi modelli vengono utilizzati per elaborare ogni token: RustingStrata sfrutta questa caratteristica mantenendo sulla GPU gli esperti che riesce a ospitare nella VRAM e gestendo gli altri attraverso la memoria di sistema.
Il posizionamento degli esperti viene inoltre adattato dinamicamente in base al loro effettivo utilizzo.
Il risultato è la possibilità di utilizzare modelli molto più grandi della memoria video disponibile, senza dover rinunciare completamente all’accelerazione GPU.
Il progetto supporta sia CUDA sia Vulkan. Nel mio caso, naturalmente, ho scelto CUDA.
Installazione: qualche ostacolo con CUDA
L’installazione su Windows è abbastanza semplice: il progetto è scritto in Rust e può essere compilato direttamente dai sorgenti con Cargo.
cargo build --releaseIl primo problema è arrivato proprio con CUDA.
Sul PC avevo già installato il CUDA Toolkit 12.8, ma RustingStrata utilizza cudarc e richiede le librerie NVRTC della versione CUDA 13. Inizialmente il motore non riusciva a inizializzare CUDA e ripiegava automaticamente su Vulkan.
La soluzione è stata scaricare dal sito NVIDIA il pacchetto standalone NVRTC 13.1, senza dover sostituire l’intera installazione del CUDA Toolkit.
Ho estratto le DLL in:
C:\AI\CUDA\13.1E ho aggiunto la directory al PATH prima di avviare il programma:
set "PATH=C:\AI\CUDA\13.1;%PATH%"Le librerie necessarie erano nvrtc64_130_0.dll e nvrtc-builtins64_131.dll.
A quel punto CUDA è stato inizializzato correttamente e i kernel sono stati compilati per l’architettura sm_86 della RTX 3060.
Il problema della calibrazione
Superato il problema CUDA, mi sono imbattuto in un secondo ostacolo.
RustingStrata dispone di un comando calibrate che misura le prestazioni del sistema e individua alcuni parametri ottimali per l’esecuzione del modello.
La prima esecuzione terminava però con un errore di copia in memoria GPU:
Error: htod: 4128768 bytes at 77660160 into 80216064Ho provato a modificare il contesto, il margine di VRAM e il formato della KV cache, senza successo.
Analizzando il codice sorgente ho individuato una possibile causa: durante la calibrazione il modello veniva caricato con tre draft MTP, una funzionalità utilizzata per la speculative decoding.
Ho quindi modificato temporaneamente il parametro nella chiamata a GpuModel::load, passando da 3 a 0, disabilitando MTP durante la calibrazione.
Dopo aver ricompilato il progetto, calibrate è finalmente terminato correttamente, generando il file JSON con i parametri misurati.
Non ho approfondito ulteriormente la causa dell’errore, ma il workaround è stato sufficiente per completare la configurazione.
Il benchmark: 121K token, stesso hardware e stesso modello
Arriviamo alla parte più interessante.
Per confrontare i due motori ho utilizzato lo stesso test già eseguito con Strata: un prompt di circa 121.000 token, costruito sul classico scenario “Ago in un pagliaio”.
L’obiettivo è verificare se il modello riesce a recuperare informazioni specifiche nascoste all’interno di una grande quantità di testo.
Per rendere il confronto significativo ho mantenuto invariati:
- Hardware: AMD Ryzen 5 9600X, 32 GB DDR5 e NVIDIA RTX 3060 da 12 GB.
- Modello:
Ornith-1.5-35B-A3B-IQ4_XS.gguf. - Prompt e domande.
I risultati sono stati decisamente interessanti.
| Metrica | Strata | RustingStrata |
|---|---|---|
| Prompt | 121K token | 121K token |
| Prefill | 340 tok/s | 730 tok/s |
| Generazione | ~30 tok/s | ~30 tok/s |
| Risposte corrette | Sì | Sì |
La differenza più evidente riguarda il prefill, cioè la fase in cui il motore legge ed elabora il prompt prima di iniziare a generare la risposta.
RustingStrata raggiunge circa 730 token al secondo contro i 340 di Strata: più del doppio, con un incremento di circa il 115%.
La velocità di generazione è invece sostanzialmente identica, intorno ai 30 token al secondo per entrambi i motori.
Non attribuirei però particolare significato a quest’ultimo dato: il test “Ago in un pagliaio” è pensato soprattutto per verificare la capacità di recuperare informazioni da un contesto molto esteso. I pochi token generati non permettono di valutare in modo significativo le prestazioni di decoding.
Un altro elemento importante è che entrambi i motori hanno fornito le risposte corrette. Non ho quindi osservato, in questo test, un peggioramento della capacità di recupero delle informazioni passando a RustingStrata.
Considerazioni finali
Il risultato mi ha sorpreso positivamente.
Il dato che considero più significativo non è tanto la velocità di generazione, rimasta sostanzialmente invariata, quanto il tempo necessario per elaborare il contesto.
Quando si utilizza un coding agent, oppure si sottopone al modello una grande quantità di codice, documentazione o cronologia delle conversazioni, il prefill può rappresentare una parte importante del tempo di attesa.
Passare da 340 a 730 token al secondo significa ridurre sensibilmente questa attesa.
Naturalmente un singolo test non è sufficiente per stabilire che RustingStrata sia sempre più veloce di Strata in qualsiasi scenario. Servirebbero ulteriori benchmark con prompt di dimensioni differenti.
Ma il risultato ottenuto sulla mia macchina è concreto: stesso modello, stesso prompt, stesso hardware e risposte corrette da entrambi i motori.
Per il momento RustingStrata ha conquistato il posto di motore principale per le mie prove di AI locale.
E pensare che tutto questo gira su una RTX 3060 da 12 GB!
Il coding locale continua a diventare sempre più interessante.