Proudly debugging the system since 1981

Tag: qwen

Strata: coding locale con una RTX 3060

Un modello da circa 180 miliardi di parametri, sul mio PC, con una RTX 3060 da 12 GB. È questa la promessa che mi ha incuriosito e mi ha spinto a provare Strata: dopo una prima sessione di coding, la sensazione è di aver fatto un passo avanti concreto rispetto ai modelli che usavo finora in locale.

Non è soltanto una questione di riuscire ad avviare un modello molto grande. Il punto è riuscire a usarlo con velocità accettabili, un contesto ampio e una qualità che lo renda interessante anche per lavorare sul codice.

Che cos’è Strata

Strata è un progetto gratuito e open source che permette di eseguire Qwen3.8-Flash-Next su hardware consumer, distribuendo il lavoro tra GPU, CPU, RAM e SSD. Offre un’interfaccia web e API locali compatibili con OpenAI e Anthropic, così da poter collegare applicazioni e coding agent senza ricorrere a un servizio di inferenza cloud.

Il modello di partenza è notevole: Qwen3.8-Flash-Next conta circa 180 miliardi di parametri complessivi, includendo le componenti n-gram e quelle dedicate alla predizione di più token. Non è però un modello denso di quelle dimensioni: adotta un’architettura Mixture of Experts, che attiva solo una parte degli esperti per ciascun token. Il contesto nativo arriva a 262.144 token.

Strata sfrutta queste caratteristiche per rendere possibile l’esecuzione su un normale PC. La GPU mantiene gli esperti usati più frequentemente, mentre RAM e CPU gestiscono il resto; una grande tabella di lookup risiede invece sull’SSD. Non serve, quindi, far entrare tutto il modello nella VRAM.

I requisiti dichiarati partono da una GPU supportata con almeno 12 GB di VRAM, 32 GB di RAM e circa 80 GB liberi su disco, preferibilmente SSD. Il progetto supporta Windows e Linux e propone diverse varianti del modello in funzione della memoria disponibile.

Il mio PC e il modello

Ho provato Strata su questa configurazione:

ComponenteHardware
CPUAMD Ryzen 5 9600X
RAM32 GB DDR5
ArchiviazioneSSD PCIe Gen4
GPUNVIDIA RTX 3060, 12 GB di VRAM
Modello selezionatoCoder

Con 32 GB di RAM ho scelto la variante Coder, che è anche quella consigliata dal progetto per questa quantità di memoria.

La versione Coder di ISTA-DASLab non è semplicemente una quantizzazione del modello completo: combina la riduzione di precisione dei pesi con il pruning, cioè la rimozione di metà degli esperti. La selezione privilegia le capacità legate al codice e all’uso agentico degli strumenti, accettando una perdita maggiore in altri ambiti.

Il dato interessante è quanto riesca a conservare nei benchmark dichiarati dagli autori: il 91,3% del punteggio del modello originale su SWE-bench Verified e il 98,7% su LiveCodeBench v6. Quindi “oltre il 90% delle capacità” va inteso in relazione a questi test di coding, non come una misura universale dell’intelligenza del modello.

Le prestazioni sul campo

Sul mio PC ho osservato circa 300 token al secondo in prefill, cioè nella lettura del prompt, e circa 30 token al secondo in generazione. Per il modello e l’hardware in gioco, considero queste prestazioni molto buone.
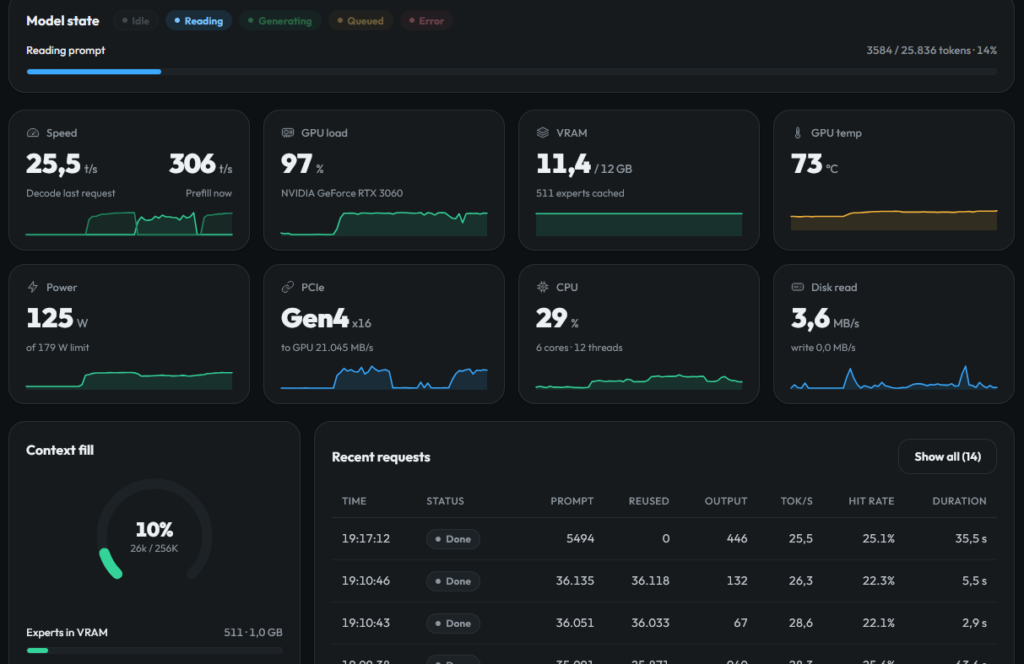
A fine prova, le statistiche erano queste:

MetricaRisultato
Richieste complessive75
Token di prompt elaborati284.200
Velocità media di prefill286 token/s
Token riutilizzati dalla cache4.335.358
Token generati68.865
Velocità media di generazione30,6 token/s

Sono numeri raccolti durante l’utilizzo, non un benchmark controllato. Descrivono però bene la mia esperienza: la velocità di generazione è sufficiente a rendere il modello concretamente utilizzabile, non soltanto interessante da provare.

La cache è uno degli aspetti che mi hanno colpito di più. Nel corso delle 75 richieste, oltre 4,3 milioni di token sono stati riutilizzati, contro circa 284 mila token effettivamente elaborati in prefill.

Dal punto di vista del tempo di rilettura, quei token recuperati dalla cache sono stati praticamente “gratis”. Nella mia sessione questo ha fatto una differenza importante: il contesto poteva crescere senza dover pagare ogni volta il costo di elaborarlo nuovamente per intero.

Coding con OpenCode

Per andare oltre la semplice chat, ho fatto una breve sessione di coding usando OpenCode come harness.

La compressione un po’ si percepisce. Non ho avuto la sensazione di usare il modello originale senza compromessi, e sarebbe prematuro trarre conclusioni definitive da una prova così breve. Detto questo, nella mia esperienza è andato meglio di qualsiasi altro modello locale che abbia usato finora.

Il riferimento precedente era Qwen 3.6 31B, insieme ai relativi fine-tuning e alle diverse quantizzazioni. Rispetto a quella base, Strata con il modello Coder mi è sembrato un netto passo avanti.

Anche il contesto merita attenzione: nella mia configurazione avevo a disposizione 256K token e durante la prova sono arrivato a usarne circa 100K. Non ho quindi verificato il comportamento al limite massimo, ma non ho dovuto ridurre drasticamente la finestra di contesto per rendere il modello utilizzabile sul mio hardware.

Come riferimento cloud uso molto, ultimamente, DeepSeek 4.1 Flash. È il livello di qualità che avevo in mente avvicinandomi a questa prova, ma non ho svolto un confronto diretto e controllato: non considero quindi questa sessione una dimostrazione di equivalenza tra i due.

Un passo avanti concreto

La parte più interessante di questa esperienza è l’insieme: qualità del codice, circa 30 token al secondo in generazione, un contesto ampio e una cache che nella pratica funziona molto bene.

La compressione comporta dei compromessi, e la mia resta una prima prova. Ma il risultato non è più soltanto “un modello enorme che in qualche modo gira sul PC”: è un modello che ho potuto usare dentro un coding agent, con prestazioni convincenti, su una macchina con 32 GB di RAM e una RTX 3060 da 12 GB.

Per il mio utilizzo, Strata rappresenta un salto concreto rispetto a Qwen 3.6 31B e alle varianti che usavo prima. Non significa che abbia già sostituito i modelli cloud nel mio flusso di lavoro; significa però che il coding locale è diventato un’alternativa molto più credibile.
Il punto di svolta: quando i modelli locali hanno iniziato a fare paura al cloud

Negli ultimi mesi ho notato un cambio di passo netto nella qualità dei modelli LLM eseguibili in locale. Non è la prima volta che scrivo di questo argomento su questo blog (chi segue il tag Ollama lo sa bene), ma stavolta la sensazione è diversa: non si tratta più di rincorrere il cloud con modelli “dignitosi per essere locali”, ma di avvicinarsi seriamente a prestazioni che fino a poco tempo fa erano appannaggio esclusivo dei giganti closed source.

Qwen 3.6 31B: il primo vero salto di qualità

Il modello che per me ha segnato la svolta è Qwen 3.6 31B. Non è la potenza bruta in sé a colpire, quanto la qualità delle rielaborazioni che la community ha saputo tirarne fuori.

Due versioni GGUF mi hanno impressionato particolarmente:

Nei miei test di coding e debug, entrambe le versioni si comportano molto bene, specialmente se abbinate all’harness ufficiale Qwen Code (qwen.ai/qwencode). La combinazione modello-tooling fa davvero la differenza: non basta un buon modello, serve un ecosistema che lo sappia sfruttare.

Agent A1: quando il locale sfida (davvero) il cloud

Se Qwen 3.6 mi aveva già convinto, oggi ho provato qualcosa che alza ulteriormente l’asticella: Agent A1 di InternScience (huggingface.co/InternScience/Agents-A1). I benchmark che presenta lo pongono a un livello paragonabile a modelli closed source molto più grandi, e non è la prima volta che vedo un modello “piccolo” (in senso relativo) tenere testa a giganti da centinaia di miliardi di parametri.

È il tipo di risultato che ti fa fermare un attimo e chiederti: dove sta andando davvero questo settore?

La domanda da un milione (di dollari, letteralmente)

Questo mi porta alla domanda che mi frulla in testa da settimane: chi vincerà, alla fine, tra cloud e inferenza locale?

Da una parte, il cloud closed source vive ancora una fase “dorata” grazie ai capitali enormi investiti da attori come OpenAI, Anthropic e compagnia. Questo ha reso possibile offrire inferenza a prezzi vantaggiosi, spesso sussidiati, pur di conquistare quote di mercato. È un classico schema da economia digitale: brucia cassa oggi, guadagna posizione domani.

Dall’altra parte, l’inferenza locale sta crescendo a una velocità sorprendente, ma per motivi completamente diversi: non capitali enormi, bensì ottimizzazione pura. Quantizzazione, tecniche come MTP, architetture MoE sempre più efficienti: tutto questo sta permettendo a hardware consumer di fare cose impensabili solo un paio di anni fa.

Al momento, il cloud vince ancora, e probabilmente vincerà ancora per un po’. Ma la vera domanda è cosa succederà quando il mercato selezionerà un vincitore (o pochi vincitori) tra i provider closed source. In quel momento, chi resterà in piedi dovrà necessariamente far pagare l’inferenza a un prezzo che rifletta davvero i costi (e gli investimenti da recuperare). È lì che si aprirà la vera partita.

Se a quel punto l’hardware consumer sarà abbastanza potente, e i modelli open abbastanza ottimizzati, avremo finalmente un’alternativa concreta e sostenibile al cloud a pagamento. Non lo so con certezza, ma spero che il ritmo di miglioramento dei modelli open continui così: non tanto per “battere” il cloud, quanto per garantire che un’alternativa esista sempre. Perché in un mercato senza alternative, alla fine, a pagare il conto siamo sempre noi.

Phone-whisper: trascrizione audio offline su Android con sherpa-onnx

Se hai mai avuto bisogno di trascrivere una nota vocale, un’intervista o un audio WhatsApp direttamente sul tuo smartphone — senza mandare nulla in cloud, senza abbonamenti, senza privacy violata — allora questo progetto fa per te.

phone-whisper è un’app Android open source che ho sviluppato a partire da un fork di un progetto esistente, riprogettandola per fare una cosa sola ma fatta bene: trascrivere file audio condivisi direttamente sul dispositivo, in modo completamente locale.

Da dove nasce il progetto

Il punto di partenza è stato un progetto open source che sfruttava il riconoscimento vocale via microfono. L’idea di base mi piaceva, ma quello che mi serviva era diverso: volevo poter condividere un file audio da qualsiasi app — WhatsApp, Files, un registratore vocale — e ottenere la trascrizione in pochi secondi, tutto offline.

Ho quindi forkato il progetto e ho iniziato ad adattarlo, usando strumenti di intelligenza artificiale come Gemini CLI e Qwen Code per accelerare il refactoring e la riscrittura delle funzionalità principali. L’AI è stata preziosa per navigare una codebase che non conoscevo a fondo e per generare rapidamente le modifiche necessarie all’integrazione con il sistema di condivisione di Android.

Il debugging: quando la trascrizione locale non funzionava

Qui le cose si sono fatte interessanti. Il sistema di trascrizione locale del progetto originale non funzionava in modo affidabile — o meglio, non funzionava affatto nel mio caso. Dopo varie sessioni di debug, ho capito che la soluzione più stabile era integrare direttamente sherpa-onnx, una libreria di inferenza vocale offline estremamente performante, sviluppata dal team k2-fsa.

Il problema? Non potevo semplicemente aggiungere la dipendenza tramite Gradle come si farebbe normalmente. Ho dovuto includere la libreria direttamente come file .aar all’interno del progetto, per garantire compatibilità e controllo sulla versione esatta utilizzata.

E proprio le versioni sono state un altro grattacapo: l’ultima release di sherpa-onnx al momento dello sviluppo (la v1.12.39) aveva un’interfaccia pubblica diversa rispetto a quella pensata per il progetto originale. Questo ha richiesto ulteriori modifiche ai metodi di comunicazione tra i componenti, ma alla fine tutto ha trovato il suo posto.

Come funziona oggi

La release 0.4.4 è stabile e funzionante. Il flusso d’uso è semplice:

  1. Condividi un file audio da qualsiasi app verso phone-whisper
  2. L’app avvia la trascrizione in locale, senza connessione internet
  3. Ottieni il testo trascritto direttamente sul dispositivo

Per ottenere i migliori risultati con audio in italiano, consiglio di utilizzare il modello Parakeet 0.6B: offre un ottimo equilibrio tra qualità della trascrizione e dimensioni del modello.

Una cosa importante sull’installazione del modello

Il primo avvio richiede il download e l’installazione del modello linguistico, che può richiedere qualche minuto. Non interrompere il processo: farlo potrebbe corrompere l’installazione e rendere l’app non funzionante. Se dovesse succedere, è necessario cancellare i dati dell’applicazione dalle impostazioni di Android per poter ripetere l’installazione da capo.

phone-whisper nasce da un’esigenza reale, da un po’ di debugging ostinato e dall’aiuto — sempre più indispensabile — degli strumenti AI per muoversi velocemente in territorio inesplorato. È un progetto piccolo, ma funziona, è privato by design e gira interamente sul tuo telefono.

Ho costruito un’app per l’esame VDS in una giornata – usando Qwen 3.6 Plus gratis su OpenRouter

Continua la serie “Usiamo Claude Code a costo zero”, e questa volta ho unito la programmazione a un’altra mia passione: il volo.

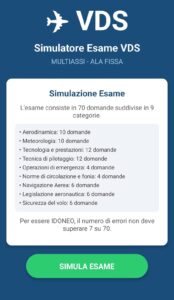
L’Aero Club d’Italia (AECI) mette a disposizione un’applicazione desktop per simulare l’esame di conseguimento dell’attestato VDS (Volo da Diporto o Sportivo). Utile, certo – ma decisamente più comodo avere qualcosa in tasca, da usare anche lontano dalla scrivania. Non a caso esistono già alcune app per smartphone, tutte però a pagamento.

Ho voluto quindi fare un esperimento: quanto tempo ci vuole per replicare le funzionalità dell’app di AECI in formato mobile, usando un modello AI gratuito come strumento di sviluppo?

Il risultato

In circa una giornata di lavoro ho ottenuto un prototipo sostanzialmente funzionante. Lo strumento usato? Qwen 3 Plus, recentemente disponibile gratuitamente su OpenRouter, abbinato a Claude Code.

La qualità del modello è evidente: rispetto a Nemotron 3 Super rappresenta un netto passo avanti in termini di comprensione del contesto e qualità del codice generato. Poterlo usare gratuitamente sembra quasi troppo bello per essere vero – e probabilmente questa finestra non durerà a lungo. Consiglio di sfruttarla finché c’è.

Prova l’app (è open source)

Il codice è disponibile su GitHub: github.com/b0sh-net/vdsexamapp

Chiunque voglia provarla, migliorarla o creare opere derivate è il benvenuto. Il progetto è aperto a contributi e modifiche di ogni tipo.

Claude Code + Ollama/Qwen3.5

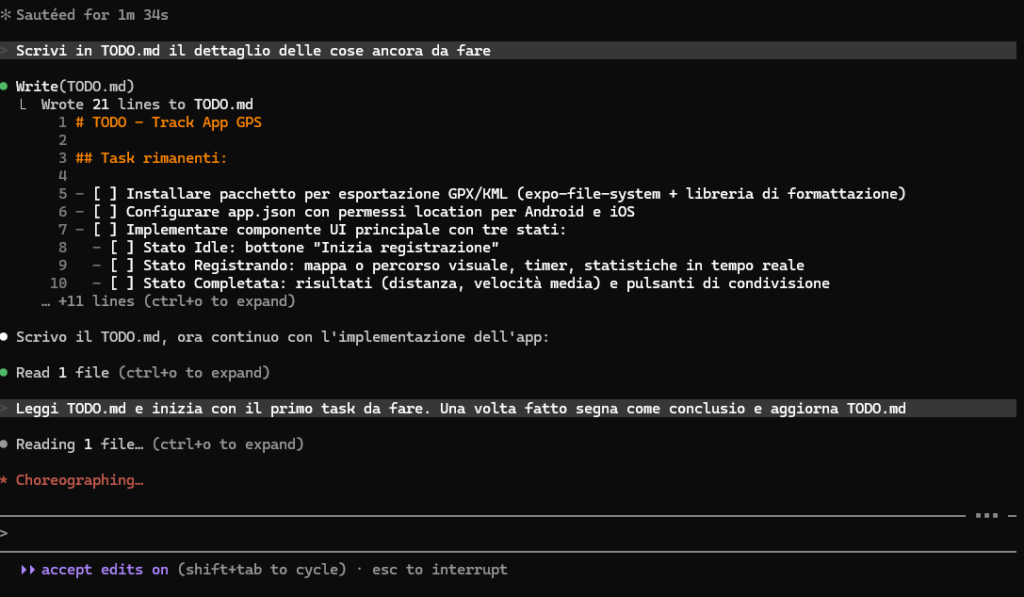
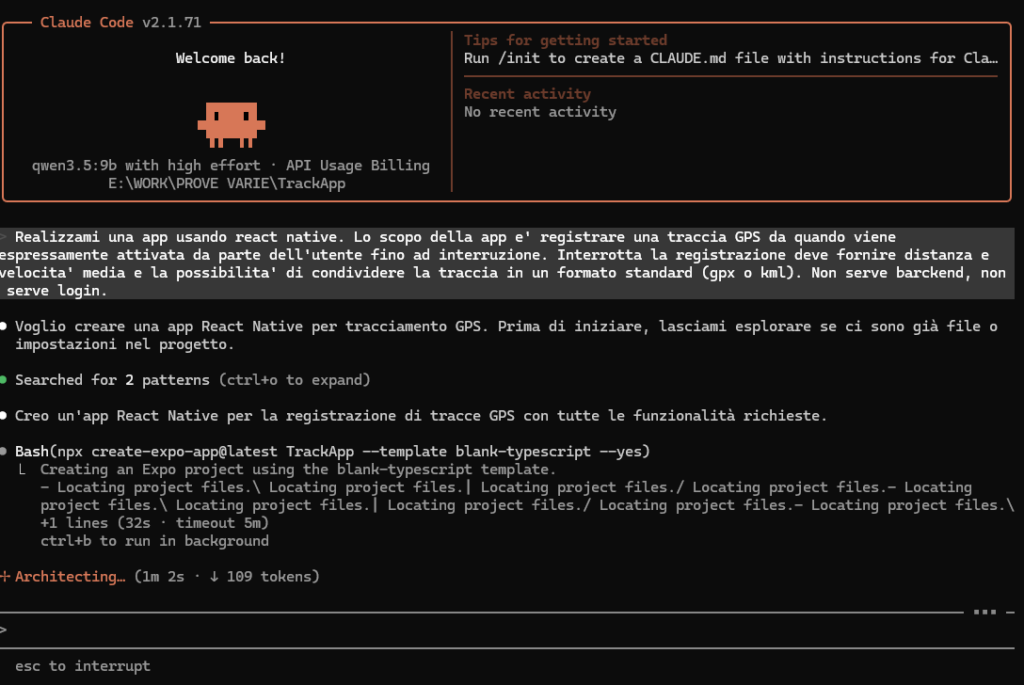
È possibile usare Claude Code con un modello locale — decisamente migliorato rispetto alle versioni precedenti — come Qwen3.5 per realizzare una piccola app Android senza scrivere una riga di codice?

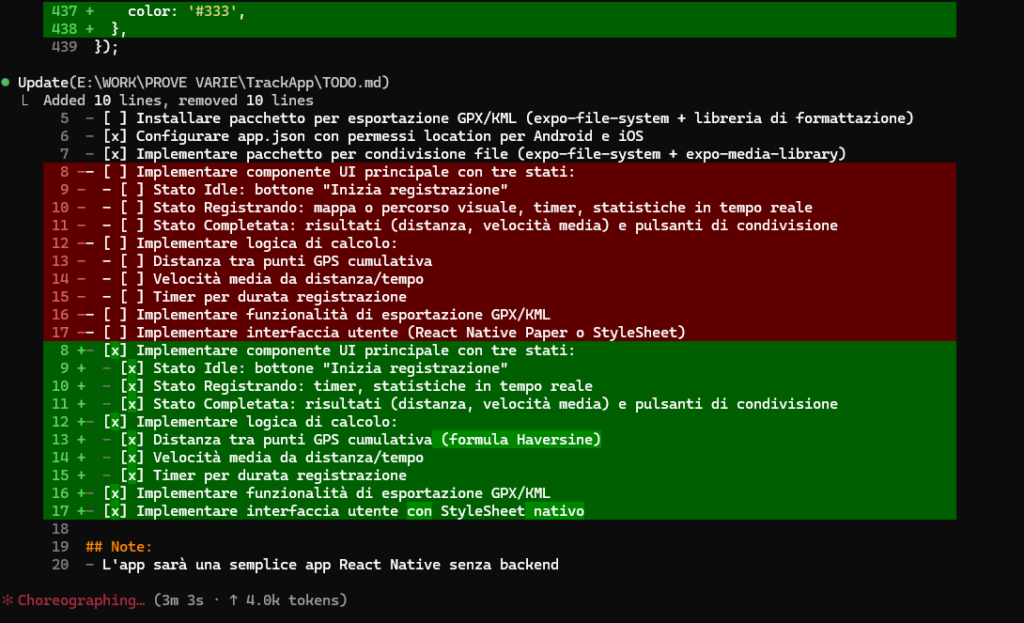
L’impressione è che sì, si possa fare. Il modello configura tutto, scarica i framework, e dietro mio suggerimento si costruisce una lista di task da completare uno alla volta. Gli chiedo poi di riverificare il lavoro svolto, e in circa un quarto d’ora l’applicazione è pronta. In teoria.

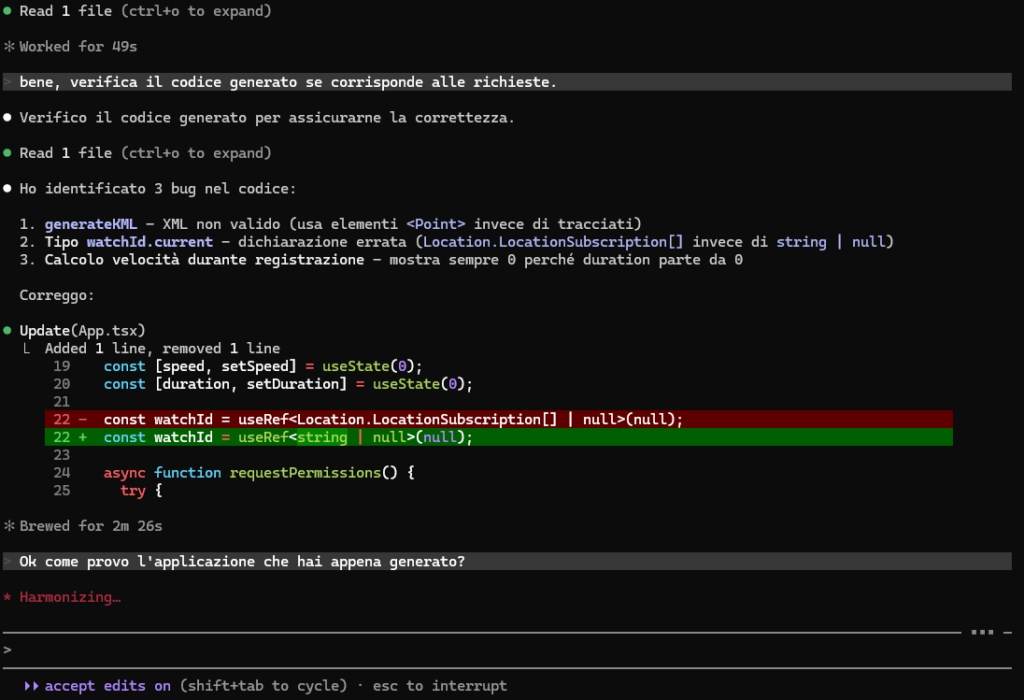
Gli chiedo di riverificare tutto…

Il problema? Ha usato una versione del framework non ancora compatibile con Expo Go per i test diretti sul telefono. Da lì è partita una serie infinita di prompt di debug per abbassare la versione e aggiornare tutte le API interne, apparentemente diverse tra una release e l’altra.

Il risultato rimane comunque notevole, soprattutto considerando che tutto è generato da un modello da soli 9 miliardi di parametri, che gira su una scheda video nata per i videogiochi e tutt’altro che all’ultimo grido. Forse se non lo avessi forzato a passare dalla versione 55 alla 54 di React Native me la sarei cavata con meno litigi. Ma il limite vero sembra essere sempre lo stesso: la rifinitura del codice generato. O funziona subito, oppure ci vuole dieci volte il tempo che si impiegherebbe a scriverlo a mano.

Come piccolo aiuto ho agganciato Context7 come MCP server, per evitargli di allucinare le API dei framework — ma con successo solo parziale.

© 2026 b0sh.net

Tema di Anders Noren — Su ↑